Makine Öğrenimi Algoritmasını Kullanarak Konuşma Sinyallerinden İyileştirilmiş Özellik Parametresi Çıkarma(2)
May 30, 2023
3.7. Veri Kümesi Veri kümesi toplama ve oluşturma işlemleri aşağıdaki şekilde gerçekleştirilmiştir. Bu çalışmada model eğitimi için 120 saatlik sesli veri seti kullanılmıştır. Veri seti, toplam uzunluğu yaklaşık 120 saat olan ve maksimum 15 kelimelik cümlelerden oluşan konuşma ses kayıtlarını içermektedir.

Çöl ginsengi
Ek olarak, veri seti, dil modelinin geliştirilmesinde kullanılmak üzere büyük miktarda farklı metin içerir. Metin külliyatında yer alan 90.650'den fazla ifade, 415.780 kelime ve 65.810 benzersiz kelime toplandı ve yaklaşık 120 saatlik yazıya dökülmüş konuşma verisi elde edildi. Veri setini eğitim, doğrulama ve test setlerine ayırdık. Veri kümesi istatistikleri
Tablo 3'te rapor edilmiştir.
Tablo 3. Veri kümesi özellikleri.

Veri setini eğitim, doğrulama ve test setlerine karşılık gelen üç klasöre ayırdık. Her klasörde ses kayıtları ve transkriptler bulunur. Ses ve karşılık gelen transkripsiyon dosya adları aynıdır, ancak ses kayıtları WAV dosyaları olarak saklanırken transkripsiyonlar UTF-8 kodlaması kullanılarak TXT dosyaları olarak saklanır. Tüm transkripsiyonlar, 29 harften oluşan Latin alfabesi ve kesme işareti kullanılarak temsil edilmiştir. Aşırı uydurmayı önlemek için, hız pertürbasyonuna ve spektral geliştirmeye dayalı veri büyütme teknikleri uyguladık.

Cistanche Deserticola
4. Önerilen Yöntem
Konuşma tanıma sistemlerini geliştirirken programcılar için önemli bir görev, konuşma sinyallerinin parametrik ifadesi için en uygun yöntemin oluşturulmasıdır [45]. Bu yöntem, seslerin ve konuşulan kelimelerin mükemmel bir şekilde ayrılmasını sağlarken, konuşmacıların telaffuz kalıplarına ve akustik ortamdaki değişikliklere duyarsız kalmasını sağlar. Kelime tanımadaki çoğu hata, mikrofondaki bir kaymaya bağlı olarak sinyalin perdesindeki bir değişiklikten veya telaffuzun perdesindeki bir farklılıktan kaynaklanır [46]. Diğer bir yaygın hata nedeni, bir konuşmacının konuşma sinyalinde her zaman mevcut olan spektrum şeklinin rastgele doğrusal olmayan deformasyonlarıdır [47,48]. Bu nedenle etkili konuşma tanıma sistemlerinin oluşturulmasında en önemli görevlerden biri, analiz edilen sinyalin içeriğine uygun, konuşmacıların seslerinden ve çeşitli akustik ortamlardan etkilenmeyen bir temsilin seçilmesidir.

Yakınımdaki Cistanche eki-Bellek Geliştirme
Özellik parametrelerini çıkarmak için kullanılan sistem tipik olarak aşağıdaki gereksinimlere sahiptir. Bilgi içeriği, yani özellik parametreleri seti, tanınabilir konuşma öğelerinin güvenilir bir şekilde tanımlanmasını sağlamalıdır. Ayrıca, ses sinyalinin maksimum sıkıştırılması ve parametrelerin istatistiksel olmayan korelasyonu olan ses şiddeti en aza indirilmelidir. Konuşmacıdan bağımsızlık da sağlanmalıdır, yani konuşmacının özelliklerine ilişkin bilgilerin karakter vektöründen azami düzeyde çıkarılması gerekir. Son olarak, aynı ortalama varyansa sahip parametreleri ve karakter kümeleri arasındaki yakınlığı belirlemek için basit metrikleri kullanma yeteneğini ifade eden homojenlik sağlanmalıdır [49]. Ancak, bu tür gereksinimler çelişkili olduğu için tüm gereksinimleri aynı anda karşılamak her zaman mümkün değildir. Konuşma öğelerinin parametrik açıklaması, onları güvenilir bir şekilde ayırt etmek için yeterince ayrıntılı olmalı ve mümkün olduğunca kısa ve öz olmalıdır.

Süpermen otlar cistanche
Uygulamada, bir mikrofondan alınan konuşma sinyali 8 ila 22 kHz örnekleme hızında sayısallaştırılır. Seri sayısal değerler, yarı durağan konuşma bölümlerine karşılık gelen, 10 ila 30 ms süreli konuşma parçalarına (çerçevelere) bölünür. Her çerçeveden, daha sonra konuşma tanımanın akustik seviyesinde kullanılan bir özellik vektörü hesaplanır. Şu anda, otokorelasyon analizine, donanım doğrusal filtrelemeye, spektral analize ve LPC'ye dayalı sinyallerin parametrik temsili için çok çeşitli yöntemler mevcuttur. Konuşma parametrelendirmesi için en yaygın yaklaşım, sinyal parçalarının spektral analizi ve cepstral katsayılarının hesaplanmasıdır.
MFCC'ler, konuşma sinyali için bilgilendirici özellikler olarak kullanılmıştır [41]. Bu özellikler konuşma tanımada yaygın olarak kullanılır ve iki ana kavrama dayanır: cepstral ve Mel ölçekleri. Algoritmanın ana avantajları, yüksek düzeyde aşinalık ve konuşma kolaylığıdır. MFCC özellikleri kaydedilen konuşma sinyallerinden ayrılmıştır. MFCC algoritması, fonogram ve spektrum değiştirme algoritmalarının sonuçlarını kullanır. MFCC'leri hesaplamak için kullanılan klasik algoritma, Şekil 5'te gösterilmektedir.

Şekil 5. MFCC'leri hesaplamak için klasik şema.
Bu çalışma, bir konuşma sinyalinden fonksiyon parametrelerinin çıkarılması için hızlı bir yöntem sunmaktadır. MFCC'lerin hızlı hesaplanması için önerilen algoritma Şekil 6'da gösterilmiştir.
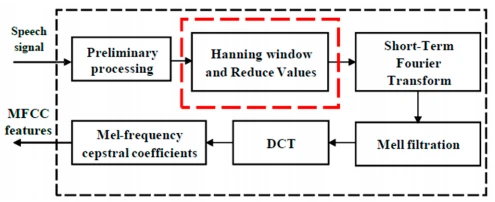
Şekil 6. MFCC'leri hesaplamak için önerilen çerçeve.
Fonksiyon parametrelerinin bir konuşma sinyalinden hızlı bir şekilde çıkarılması için önerilen algoritmanın yürütme sırasını göz önünde bulunduruyoruz.
4.1. Çerçevelere Bölme
Ön filtrelemenin ardından, konuşma sinyali 16 ms'lik çerçevelere bölünür. Her kare (ilki hariç) bir önceki karenin son 10 ms'sini içerir. Bu işlem sinyalin sonuna kadar devam eder. Bu çalışmada, konuşma sinyalinin örnekleme hızı 16 kHz olduğundan çerçeve uzunluğu N=256 ve ofset uzunluğu M=160'dir. Örtüşme, çerçeve uzunluğunun yüzde 62,5'idir. Genellikle çerçeve uzunluğunun yüzde 50 ila yüzde 75'i kadar bir kapsama alanı önerilir.
4.2. Hanning Penceresi ve Azalan Değerler
1D'lik bir Hanning penceresi boyutu kullanıldı. Hanning penceresi aynı zamanda yükseltilmiş kosinüs penceresi olarak da adlandırılır. Hanning penceresi, üç dikdörtgen zaman penceresinin frekans spektrumunun toplamı olarak düşünülebilir. Yüksek frekanslı girişimi ve enerji sızıntısını ortadan kaldırarak birbirini iptal etmek için yan lobları kullanabilir. Hanning pencereleri çok kullanışlı pencere işlevleridir.

Yakınımdaki Cistanche eki-Bellek Geliştirme
【Daha fazlasını isteyin】 E-posta:cindy.xue@wecistanche.com / Whats App: 0086 18599088692 / Wechat: 18599088692
Bozulmayı azaltmak ve tek tek kareleri yumuşatmak için bir ağırlık kutusu kullanılır. Bu çalışmada incelenen kayan sinyal, yoğun bir tondan oluşmaktadır. Düz tonun büyüklüğü, Hanning penceresinden filtrelenen f frekansındaki saf tonun büyüklüğü ile belirlenir.
Bu pencerenin kritik bir yönü, çerçevelerin kenarlıklarını sıfıra ayarlamasıdır. Bu durumda pencereden geçerken kısa enerjiler hesaplanabilir ve en düşük genlikli enerjileri hesaplamak için kullanılan diziden aktarılabilir. Amaç bu pencereden sinyali yumuşatırken sinyal enerjisini hesaplayarak düşük enerjili sinyalleri sinyalden uzaklaştırmaktır. Bu işlem, aşağıdaki sinyal enerjisi denklemini gerektirir:

En, giriş sinyali parçasının enerjisi ve xi, sinyal değeridir.
(11) kullanılarak pencere işlemine ek olarak, sinyal, işlemciye giren değerlerin sayısını önemli ölçüde azaltan bir sonraki adımda işlenir. Şekil 7, paralel işleme algoritmasını sunar.
Pencere boyutu, bir dizi örneği ve bir süreyi temsil eder. Analizin ana parametresidir. Pencere boyutu, temel frekansa, yoğunluğa ve sinyaldeki değişikliklere bağlıdır.

Şekil 7. Sessiz bölümleri kaldırmak için Hanning penceresi algoritması. 4.3. Kısa Süreli Fourier Dönüşümü (STFT) Anahtarları Yüksek veya alçak yüksekliğin anlamına ilişkin sezgisel bir anlayış mevcuttur. STFT, zaman içinde değiştikçe bir sinyalin yerel bölümlerinin sinüzoidal frekansını ve faz içeriğini belirlemek için kullanılan Fourier ile ilgili bir dönüşümdür. Uygulamada, STFT hesaplaması, daha uzun bir zaman sinyalinin eşit uzunlukta daha kısa parçalara bölünmesini içerir, ardından her bir daha kısa segmentte Fourier dönüşümünün ayrı bir hesaplaması yapılır. Bu, her daha kısa segmentin Fourier spektrumunu ortaya çıkarır. Ayrık zamanlı sinyaller pratikte kullanılır. Karşılık gelen zaman-frekans dönüşümü, Xn sinyalinin uzunluğunu N katsayılarının karmaşık değer frekans alanının temsilcisi olarak tanımlayan ayrık bir Fourier dönüşümüdür. Zaman içinde frekans bileşenlerinin gelişimini açıklayan STFT, konuşma analizi ve işleme için en yaygın kullanılan araçlardan biridir [50]. Spektrumun kendisine benzer şekilde, STFT'nin bir avantajı, parametrelerinin fiziksel ve sezgisel yorumlara sahip olmasıdır. STFT tipik olarak log spektrumları 20log10 (X(h, k)) kullanılarak görselleştirilir. Bu tür 2B log spektrumları daha sonra spektrogram olarak bilinen bir termal harita kullanılarak görüntülenebilir. Algoritmanın üçüncü aşamasında, ağırlık penceresinden geçen çerçevelere STFT spektral anahtarlama prosedürü uygulanmaktadır. Sinyalin STFT'si, pencerelerin açılması ve her pencerenin DFT'sinin belirlenmesiyle elde edilir. Özellikle, giriş sinyalinin Xn ve Wn pencereleri için dönüşüm şu şekilde belirlenir:

burada k-endeksi frekans değerlerine karşılık gelir ve wn genellikle sıfır etrafında ortalanmış bir Hanning penceresi veya Gauss penceresi olan pencere işlevidir.
4.4. Mel Dönüşümü
Dördüncü aşamada frekans bandına aktarılan sinyal üçgen filtreler kullanılarak aralıklara bölünür. Filitre sınırları, tebeşir frekansı kullanılarak hesaplanır. Tebeşir frekansı alanına geçiş aşağıdaki denkleme dayanmaktadır:
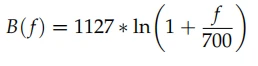
burada f, frekans aralığıdır.
Ters anahtar aşağıdaki gibi belirlenir:

NN'yi, incelenen frekans aralığı kadar yüksek olan, filtre sayısı (genellikle 26 filtre kullanılır) ve akış akışları olarak düşünün. Bu aralık Mel ölçeğine aktarılır ve NN eşit dağılmış kesişen aralıklara bölünür. Doğrusal frekansa uygun sınırlar, alan içinde belirlenirken, filtrelemeye dayalı olarak elde edilen ağırlıklandırma katsayıları H ile gösterilir. Ardından, filtreler, Fourier dönüşümünden elde edilen katsayıların kare modülüne uygulanır. Elde edilen değerler aşağıdaki ifade sayesinde logaritmiktir:

Tekil değer ayrıştırma algoritması, MFCC'lerin hesaplanmasının son aşamasında uygulanır.
5. Deneysel Sonuçlar
Önerilen yöntemi Tablo 4'te gösterildiği gibi 4,90 GHz CPU, 32 GB RAM ve iki Nvidia GeForce 2080Ti GPU'ya sahip bir PC'de Visual Studio 2019 C plus plus'ta uyguladık ve test ettik. Sistem, farklı cihaz ortamlarında test edildi. sinyal öznitelik çıkarma yönteminin performansını değerlendirir. Deneylerde, algoritmanın çalışması sırasında (Şekil 8), sinyalin yüzey dizisi n=15 olduğunda, değer sayısı yüzde 40-50 oranında azaldı ve işlem süresi 1 arttı. 2-katlayın. Sonuç olarak, bu algoritma önemli ölçüde daha yüksek verimlilik sergiledi. Ayrıca bu algoritma, Hanning penceresinden geçerken sessiz alanların ayrılmasını ve ortadan kaldırılmasını sağlamıştır.
Bellek bant genişliği israfını önlemek için birkaç olası yol mevcuttur. Sinyal çerçevelerinin boyutunu bir blok önbellek boyutuyla eşleştirerek bilgi işlem performansını artıran yeni bir çözüm öneriyoruz. Bu tür bir optimizasyon, genel paralel işleme performansını önemli ölçüde etkileyebilir. Ancak, çok çekirdekli işlemciler üzerindeki uygulamalarla sinyali çerçevelere bölerek dijital sinyal işlemede kullanılabilir. Bununla birlikte, pratikte, seçim genellikle önbelleği ana belleğe bağlayan veri yolunun genişliğine ve bloğunun boyutuna karşılık gelen küçük bir ölçekte gerçekleştirilir. Yöntemimiz, paralel hesaplamada bu belleklerin optimum kullanımını uygular. Önbelleğin organizasyonu, verileri akışlara bölerken paralel işleme algoritmalarında önemli bir rol oynar. Özellikle dijital sinyal işlemede vektör matris efektlerinin varlığı ve akışlarının boyutu, önbellek bloklarının boyutuna göre ayarlanmalıdır. Bu, Şekil 9'da gösterildiği gibi, önerilen yöntem kullanılarak elde edilebilir.
Tablo 4. Deney düzeneğinin ayrıntılı özellikleri.


şekil 8. (a) İlk gelen sinyal ve (b) önerilen algoritmayı uyguladıktan sonra sinyalin görünümü.

Şekil 9. RK3288 işlemcileri kullanan paralel bilgi işlem yapısı.
Bu bölümde, farklı sistemlerin performansını karşılaştırmak için nicel bir analizi ele alıyoruz. Yöntemimizi, derin öğrenme yaklaşımlarına dayalı iyi bilinen konuşma tanıma algoritma ritimleriyle karşılaştırdık. Değerlendirme ölçütleri, konuşma tanıma için çeşitli stratejilerin hesaplanması ve farklı yaklaşımların performansının değerlendirilmesi için gereklidir. Karşılaştırma için diğer çalışmaların sonuçlarını kullanmış olsak da, bunların doğru olup olmadığından emin değiliz çünkü bu yöntemlerin kaynak kodları ve veri kümeleri, gerçek performansı doğrulamak için halka açık değildir. Şekil 10, önerilen hızlı algoritmaya dayalı olarak bir konuşma sinyali parçasının Hanning penceresinden geçişi sırasında sessiz bölümlerin hareket ettirilmesinin sonucunu göstermektedir. Analizden elde edilen hız sonuçları Tablo 5'te sunulmuştur.

Şekil 10. KNN algoritmasının k değeri (özellik seçimli).
Tablo 5. Önerilen yöntemin deneysel sonuçları.

KNN algoritmasında en iyi doğruluk değerini veren komşuluk derecesini bulmak için bir aralık belirlenmiştir. Belirtilen aralık 1–25'i kapsar. Şekil 10'da özellik seçimli KNN algoritmasının grafiği uygulanmıştır. Grafik incelendiğinde başlangıçta komşuluk değeri 1 iken eğitim doğruluğu test doğruluğundan çok daha yüksek çıkmıştır. Korelasyonla seçilen öznitelikler kullanılarak oluşturulan KNN algoritmasında modelin doğruluğu eğitim veri setinde yüzde 99,15, test veri setinde ise yüzde 97,35 olarak belirlendi.
Sözcük hata oranı (WER) veya karakter hata oranı, genellikle bir konuşma sinyalinden özellik çıkarımının doğruluğunu değerlendirmek için kullanılır. Bunlar, tanıma tekniklerinin adil bir şekilde karşılaştırılmasına yardımcı olan nesnel matrislerdir. Önceki çalışmalarımızda [51–56], F-ölçüsü (FM), kesinlik ve geri çağırma gibi metrikleri hesapladık. FM, kesinlik ve geri çağırma oranları arasındaki ölçümleri dengeleyen ağırlıklı ortalamadır. Kesinlik, doğru tahmin edilen pozitif gözlem sayısının, tahmin edilen pozitif gözlemlerin toplam sayısına oranıdır. Hatırlama, (9)'da belirtildiği gibi, doğru tahmin edilen pozitif gözlem sayısının gerçek sınıftaki toplam gözlem sayısına oranıdır. Özellik çıkarma yöntemlerinin ortalama kesinliğini ve geri çağırma oranlarını hesaplamak için aşağıdaki denklemler kullanılabilir:

TP, doğru pozitiflerin sayısını, FP, yanlış pozitiflerin sayısını ve FN, yanlış negatiflerin sayısını gösterir.
FM, hem kesinlik hem de geri çağırma dikkate alınarak (10) kullanılarak hesaplanır.

Önerilen yöntemin ortalama FM, hatırlama ve kesinliği yüzde 98,4 idi. Mikrofondaki sinyallerin istenmeyen gürültüsü nedeniyle vakaların yüzde 1,6'sında yanlış algılama meydana geldi. Modelin doğruluk aralığı 0 ile 1 arasındaydı ve metrik tahmin puanları en iyi değerlerine 1'de ulaştı. Yöntemimizin ve yakın zamanda yayınlanan diğer konuşma özelliği çıkarma yöntemlerinin bir değerlendirmesi Tablo 6'da sunulmaktadır. özelliklerin adil bir karşılaştırma için kullanılmıştır. Her gruptan toplam 325 konuşma örneği, benzer özellik geçmişlerine sahip deneklerden analiz edildi. MFCC'deki fifilter bankalarının sayısına göre farklı çerçeve uzunluklarının ve LPC sırasına göre farklı çerçeve uzunluklarının etkileri de geliştirilmiş doğruluk için incelenmiştir.
Tablo 6. Konuşma özelliği çıkarımının nicel doğruluk sonuçları.

Daha önce bahsedildiği gibi, WER konuşma tanıma performansı için en yaygın ölçüdür. Bir referans transkripsiyonu ile konuşma tanıyıcının çıktısını karşılaştırarak hesaplanır. Bu karşılaştırmaya dayanarak, tipik olarak üç kategoriye ait olan hata sayısını hesaplamak mümkündür: (1) otomatik konuşma tanımanın (ASR) çıktısında referansta bir kelime bulunmadığında yapılan eklemeler, (2) ASR çıktısında bir kelime eksik olduğunda silmeler ve (3) bir kelime başka bir kelime ile karıştırıldığında ikameler. WER aşağıdaki gibi hesaplanabilir.

burada S, yanlış tanınan sözcüklerin ikame sayısıdır, D, silme sayısıdır, I, eklemelerin sayısıdır ve N, referans transkripsiyondaki sözcüklerin sayısıdır. Bu puanın hesaplanmasındaki ana sorun, iki kelimelik diziler arasındaki hizalamadır. Bu, Levenshtein mesafesi [67] kullanılarak dinamik programlama yoluyla belirlenebilir.
Tablo 6'ya dayanarak, Şekil 11'de gösterildiği gibi, WER değerlendirme metriğini kullanarak karşılaştırılan yöntemlerin ortalama doğruluğunu belirtmek için istatistiksel bir analiz gerçekleştirdik. Yüzde 78 ve yüzde 96. Karşılaştırma için ilgili belgelerde sağlanan sonuçları kullandık; ancak, bu yöntemlerin kaynak kodları ve veri kümeleri, gerçek performanslarını doğrulamak için kamuya açık olmadığından, bu değerlerin doğruluğu kolayca doğrulanamaz. Bununla birlikte, standart sahneler söz konusu olduğunda, önerilen yöntemin, konuşma verileri gürültülü veya düşük kaliteli olsa bile hesaplama süresini azaltarak mükemmel konuşma özelliği çıkarma doğruluğu sağladığı deneysel olarak gösterildi.

Şekil 11. Dikey grafikler kullanılarak konuşma sinyali özellik çıkarma yaklaşımlarının nicel sonuçları.
Ayrıca, seçilen yöntemlerin yanlış pozitif sonuçlarını değerlendirdik. Şekil 12'den de görülebileceği gibi, önerilen yaklaşım en az hataya sahipti. Ayrıca, oldukça verimli paralel hesaplama yöntemi, ses sinyali özellik seçimi ve ayıklama hatalarını önemli ölçüde azaltmıştır. Aşırı uyum, eğitim sırasında ana sorunlardan biriydi ve neredeyse tüm makine öğrenimi modelleri bundan muzdarip. Bunun yerine veri kümesindeki mevcut özelliklerin önemini sıralamayı ve daha az önemli olanları atmayı amaçlayan (yeni özellikler oluşturulmaz) bir özellik seçme tekniği kullanarak aşırı uydurma riskini azaltmaya çalıştık.

Şekil 12. Yanlış pozitif konuşma sinyali özelliği çıkarma deneylerinin görünür sonuçları.
Tablo 7, konuşma tanıma ortamlarında kullanılan yöntemlerin farklı özelliklere göre performans sonuçlarını göstermektedir. Önerdiğimiz yaklaşım, istenmeyen ve gereksiz arka plan gürültüsünden etkilenmez ve kısık sesler, boğaz ağrısı ile üretilen sesler gibi düşük kaliteli insan seslerinden ve hatta tamamen ses kaybı olan insanlardan gelen seslerden etkilenmez. Metodumuz, yetersiz kayıt ekipmanı, arka plan gürültüsü, zor aksanlar ve lehçeler ve sesteki çeşitli perdeler gibi sorunların üstesinden gelmeyi amaçlamaktadır. Normal bir ortamda, konuşma özelliği zorluklarını doğru bir şekilde tespit etmek ve ayıklamak için en iyi sonuçlar, azaltılmış işlem süresi ile önerilen yöntem kullanılarak elde edildi.
Tablo 7. Çeşitli özellikleri kullanarak konuşma özelliği algılama ve ayıklama performansının gözden geçirilmesi.

Konuşma tanıma yöntemlerinin sonuçları yedi kategori için güçlü, normal veya zayıf olarak sınıflandırıldı. Güçlü kriter, algoritmanın her türlü zorluğun üstesinden gelebileceğini göstermektedir. Bunun tersine, normal kriter, kelime sınırları önceden tanımlanmadığı için algoritmanın belirli durumlarda başarısız olabileceğini belirtir. Son olarak, zayıf kriter, algoritmanın arka plan gürültüsü veya titreşimler altında güvenilmez olduğunu gösterir.
6. Sınırlamalar
Bugüne kadar önerilen yöntemlerin herhangi bir eksiklik göstermediği sonucuna varmak zordur. Önerilen yöntemimiz ayrıca çeşitli gürültü ortamları nedeniyle hatalara neden olabilir. Bu sorunu aşmak için var olan özelliklerden yeni özellikler oluşturarak veri setindeki öznitelik sayısını azaltmayı amaçladık [69]. Yarışma sırasında farklı modellerin eğitimi için en önemli sorunlardan biri aşırı uyum olduğundan, eğitim verilerini farklı kaynaklardan veri örnekleri ekleyerek zenginleştirmek, sonuçları iyileştirmek için olası bir çözüm olabilir. Yukarıda belirtilen sorunlardan bağımsız olarak, deneysel sonuçlar, yöntemimizin ortalama yüzde 98,4 doğruluk ve yüzde 99,5 FM ile konuşma özelliği çıkarma görevleri için çok sağlam ve etkili olduğunu ortaya koydu.
7. Sonuçlar
Konuşma tanıma sistemleri için bir makine öğrenme yöntemi kullanan yeni bir yüksek performanslı paralel bilgi işlem yaklaşımı önerilmiştir. Sınırlı bilgi işlem kaynaklarına sahip makinelerdeki hızlanma sorunları, dağıtılmış sistemler kullanılarak çözülebilir. Etkin ve hızlı algoritma ritmleri oluşturularak ve kullanılarak sinyal tanıma sistemlerinde hesaplama hızı arttırılabilir ve çok çekirdekli platformların performansı iyileştirilebilir. Sonuçlar, önerilen modelin işlem süresini azalttığını ve MFCC'leri etkin bir şekilde kullanarak öznitelik çıkarma doğruluğunu yüzde 98,4 oranında iyileştirdiğini göstermektedir. Öznitelik seçimi ile çıkarılan düşük korelasyon değerlerine sahip özniteliklerin de modelin başarısında etkili olduğu görülmüştür. Ön işleme tabi tutulmuş veriler üzerinde istatistiksel analizler yapılmış ve K-en yakın komşular (KNN) makine öğrenmesi algoritması kullanılarak verilerden anlamlı bilgiler üretilmiştir.
Gelecekteki çalışmalar, derin öğrenme yaklaşımlarını kullanarak ve çok çekirdekli işlemcilerin önbelleğini önemli bir kalite kaybı olmadan konuşma sinyallerini algılayıp ayıklamak için optimize ederek yöntemimizin doğruluğunu geliştirmeye odaklanacaktır. Ayrıca, 3D CNN ve 3D U-Net Ortamında [71–) Taris konuşma veri setlerini [70] kullanarak düşük hesaplama kaynaklarına sahip gömülü cihazların kurulmasını sağlayacak sağlam analiz performansına sahip paralel işlemeye dayalı bir spektral analiz modeli oluşturmayı planlıyoruz. 75]
Referanslar
1. Meng, YJ; Liu, WJ; Çang, RZ; Du, HS Konuşma Özelliği Parametre Çıkarımı ve Enterpolasyona Dayalı Tanıma. Uygulama makine Anne. 2014, 602–605, 2118–2123. [CrossRef] 2. Musaev, M.; Rakhimov, M. Konvolüsyonel Sinir Ağları için Hızlandırılmış Eğitim. 2020 Uluslararası Bilgi Bilimi ve İletişim Teknolojileri Konferansı (ICISCT) Bildiri Kitabında, Taşkent, Özbekistan, 4–6 Kasım 2020; s. 1–5. [CrossRef] 3. Ye, F.; Yang, J. Konuşmacı Tanımlaması için Derin Bir Sinir Ağı Modeli. Uygulama bilim 2021, 11, 3603. [CrossRef] 4. Musaev, M.; Rakhimov, M. Konuşma Sinyalinin Paralel İşlemesinde Ana Bellek Bloğunu Önbelleğe Eşleme Yöntemi. 2019 Uluslararası Bilgi Bilimi ve İletişim Teknolojileri Konferansı (ICISCT) Bildiri Kitabında, Karaçi, Pakistan, 9–10 Mart 2019; s. 1–4. [CrossRef] 5. Jiang, N.; Liu, T. SOM ve k-aracına dayalı gelişmiş bir konuşma bölümleme ve kümeleme algoritması. Matematik. Sorun Müh. 2020, 2020, 3608286. [CrossRef] 6. Hu, W.; Yang, Z.; Chen, C.; Güneş, B.; Xie, Q. Sayısal kontrol taretinin çok eylemli sistemi için bir titreşim segmentasyonu yaklaşımı. Sinyal Görüntüsü Video İşlemi. 2021, 16, 489–496. [ÇaprazRef]
7. Popescu, TD; Aiordachioaie, D. Titreşimli sinyallerin optimum bölümlemesini kullanarak rulman yataklarında arıza tespiti. makine Sist. Sinyal İşlemi. 2019, 116, 370–391. [CrossRef] 8. Shihab, MSH; Aditya, S.; Setu, JH; Imtiaz-Ud-Din, KM; Efat, MIA Konuşmacı Tanımlaması için Hibrit GRU-CNN Özellik Çıkarma Tekniği. 2020 23. Uluslararası Bilgisayar ve Bilgi Teknolojileri Konferansı (ICCIT), Dhaka, Bangladeş, 19–21 Aralık 2020 Tutanakları'nda; s. 1–6. [CrossRef] 9. Korkmaz, Ö.; Atasoy, A. Mel-frekans cepstral katsayıları kullanılarak konuşma sinyalinden duygu tanıma. 9. Uluslararası Elektrik ve Elektronik Mühendisliği Konferansı (ELECO) Bildiri Kitabında, Bursa, Türkiye, 26–28 Kasım 2015; sayfa 1254–1257. 10. Ayvaz, Ü.; Gürler, H.; Han, F.; Ahmed, N.; Whangbo, T.; Abdusalomov, A. Makine Öğrenimi Yoluyla Mel-Frekans Cepstral Katsayılarını Kullanarak Otomatik Konuşmacı Tanıma. CMC-Bilgisayar. Anne. devam 2022, 71, 5511–5521. 11. El-Kadiri, M.; Lahamer, E.; Rad, A. Heterojen Sınıflandırıcıların Füzyonu ve Tamamlayıcı Özellik İşbirliği Yoluyla İki Seviyeli Konuşmacı Tanıma Sistemi. Sensörler 2021, 21, 5097. [CrossRef] 12. Batur Dinler, Ö.; Aydın, N. Konuşma Segmenti Tespiti için Geçitli Tekrarlayan Birim Tekrarlayan Sinir Ağlarına Dayalı Optimal Bir Özellik Parametre Seti. Uygulama bilim 2020, 10, 1273. [CrossRef] 13. Kim, H.; Shin, Sızıntı Önleme ve Sinyal Kurtarma ile TF-GSC'ye Dayalı JW Çift Mikrofonlu Konuşma Geliştirme. Uygulama bilim 2021, 11, 2816. [CrossRef] 14. Lee, S.-J.; Kwon, H.-Y. Konuşma Segmenti Tespitine Dayalı Konuşma Verilerinin Gürültüden Arındırılması İçin Bir Ön İşleme Stratejisi. Uygulama bilim 2020, 10, 7385. [CrossRef] 15. Rusnac, A.-L.; Grigore, O. CNN Mimarileri ve EEG Hayali Konuşma Tanıma için Özellik Çıkarma Yöntemleri. Sensörler 2022, 22, 4679. [CrossRef] [PubMed] 16. Wafa, R.; Han, MQ; Malik, F.; Abdusalomov, AB; Cho, Yi; Odaarchenko, R. Pakistan'ın BT Endüstrisinde Kişinin İş Uyumunun Düzenleyici Rolüyle Çevik Metodolojinin Proje Başarısı Üzerindeki Etkisi. Uygulama bilim 2022, 12, 10698. [CrossRef] 17. Aggarwal, A.; Srivastava, A.; Agarwal, A.; Chahal, N.; Singh, D.; Alnuaim, AA; Alhadlaq, A.; Lee, H.-N. Derin Öğrenmeyi Kullanarak Konuşma Duygu Tanıma için İki Yönlü Özellik Çıkarma. Sensörler 2022, 22, 2378. [CrossRef] [PubMed] 18. Marini, M.; Vanello, N.; Fanucci, L. Dizartrili Kişiler İçin Otomatik Konuşma Tanıma Performansını Artırmak İçin Konuşmacıya Bağlı Özellik Çıkarma Parametrelerini Optimize Etme. Sensörler 2021, 21, 6460. [CrossRef] 19. Tiwari, S.; Jain, A.; Şarma, AK; Almustafa, KM Fonokardiyogram Sinyal Tabanlı Çok Sınıflı Kardiyak Tanısal Karar Destek Sistemi. IEEE Erişimi 2021, 9, 110710–110722. [CrossRef] 20. Mohtaj, S.; Schmitt, V.; Möller, S. Nefret Söylemini Belirlemeye Yönelik Özellik Çıkarma Temelli Bir Model. arXiv 2022, arXiv: 2201.04227. 21. Kuldoshbay, A.; Abdusalomov, A.; Muhiddinov, M.; Baratov, N.; Mahmudov, F.; Cho, YI CNN'de kullanılan ultrason görüntüleri için otomatik sınıflandırma yönteminde bir iyileştirme. Int. J. Dalgacıklar Çoklu Çözünürlük Inf. İşlem. 2022, 20, 2150054. 22. Passricha, V.; Aggarwal, RK Otomatik konuşma tanıma için derin CNN ve çift yönlü LSTM'nin bir karışımı. J. İstihbarat Sist. 2020, 29, 1261–1274. [CrossRef] 23. Mukhamadiyev, A.; Khujayarov, İ.; Djuraev, O.; Cho, J. Özbek Dili için Derin Öğrenme Yaklaşımlarına Dayalı Otomatik Konuşma Tanıma Yöntemi. Sensörler 2022, 22, 3683. [CrossRef] [PubMed] 24. Li, F.; Liu, M.; Zhao, Y.; Kong, L.; Dong, L.; Liu, X.; Hui, M. 1D evrişimli sinir ağları kullanılarak kalp sesinin özellik çıkarımı ve sınıflandırılması. EURASIP J. Av. Sinyal İşlemi. 2019, 2019, 59. [CrossRef] 25. Chang, L.-C.; Asılı, J.-W. Derin Akustik Modellerde Durumların Olasılığının Maksimize Edilmesine Dayalı Sağlam Konuşma Özelliği Çıkarımına İlişkin Bir Ön Çalışma. Uygulama Sist. Yenilik 2022, 5, 71. [CrossRef] 26. Ramírez, J.; Gorriz, JM; Segura, JC Ses Etkinliği Algılama. Temel Bilgiler ve Konuşma Tanıma Sistemi Sağlamlığı. Güçlü Konuşma Tanıma ve Anlamada; Grimm, M., Kroschel, K., Ed.; I-TECH Eğitim ve Yayıncılık: Londra, İngiltere, 2007; s. 1–22. 27. Oh, S. DNN Tabanlı Güçlü Konuşma Özelliği Çıkarma ve Konuşma Tanıma için Gelişmiş Ortalama Tahmin LMS Filtresi Kullanarak Sinyal Gürültüsü Giderme Yöntemi. J. Converg. bilgi Teknoloji 2021, 11, 1–6. [CrossRef] 28. Abbaschian, BJ; Sierra-Sosa, D.; Elmaghraby, A. Veritabanlarından Modellere Konuşma Duygu Tanıma için Derin Öğrenme Teknikleri. Sensörler 2021, 21, 1249. [CrossRef] 29. Rakhimov, M.; Mamadjanov, D.; Mukhiddinov, A. Dağıtılmış Hesaplamada Görüntü İşleme için Yüksek Performanslı Paralel Bir Yaklaşım. 2020 IEEE 14th International Conference on Application of Information and Communication Technologies (AICT), Özbekistan, Taşkent, 7–9 Ekim 2020 Bildiri Kitabında; s. 1–5. [CrossRef] 30. Abdusalomov, A.; Muhiddinov, M.; Djuraev, O.; Khamdamov, Ü.; Whangbo, TK Dokunsal Grafikler Oluşturmak için Yerel Olarak Uyarlanabilir Eşiğe Dayalı Otomatik Çıkıntılı Nesne Çıkarma. Uygulama bilim 2020, 10, 3350. [CrossRef] 31. Abdusalomov, A.; Whangbo, TK İç ortamlar için gölge giderme tekniği kullanılarak ön plan tanıma yöntemi için bir iyileştirme. Int. J. Dalgacıklar Çoklu Çözünürlük Inf. İşlem. 2017, 15, 1750039. [CrossRef] 32. Abdusalomov, A.; Whangbo, TK İç Mekan Video Akışları için Geometri ve Renk Bilgilerini Kullanarak Hareketli Nesne Gölgelerinin Tespiti ve Kaldırılması. Uygulama bilim 2019, 9, 5165. [CrossRef] 33. Mery, D. Röntgen Testi için Bilgisayarla Görü; Springer Uluslararası Yayıncılık: Cham, İsviçre, 2015; P. 271, ISBN 978-3319207469. 34. Mark, S. Konuşma görüntüleri, konuşma-algı sınırlarını yeniden ayarlar. Dikkat Algı. Psikofiz. 2016, 78, 1496–1511. [CrossRef] 35. Mudgal, E.; Mukuntharaj, S.; Modak, MÜ; Rao, DSP-TMS320F28335'te Dijital Filtreler Kullanan YS Şablon Tabanlı Gerçek Zamanlı Konuşma Tanıma. 2018 Dördüncü Uluslararası Bilgi İşlem İletişim Kontrolü ve Otomasyonu Konferansı (ICCUBEA) Bildirilerinde, Pune, Hindistan, 16–18 Ağustos 2018; s. 1–6. [ÇaprazRef]