Müzik Öğretiminde Derin Sinir Ağına Dayalı Ses Tanıma Araştırması
Oct 10, 2023
Solfej, müzik dalları için önemli bir temel derstir ve ses tanıma eğitimi de önemli bağlantılardan biridir. Bilgisayar performansının artmasıyla birlikte ses tanıma, akıllı giyilebilir cihazlarda yaygın olarak kullanılmaya başlandı. Son yıllarda derin öğrenmenin gelişimi ses tanıma araştırma sürecini hızlandırdı. Ancak müzik öğretimi ortamında çok fazla ses paraziti vardır ve bu da ses sınıflandırıcının gerçek talebi karşılayamayan performansına yol açar. Bu sorunu çözmek için, esas olarak ağ yapısını iyileştiren, YOLO-v4'ü temel alan geliştirilmiş bir ses tanıma sistemi önerilmiştir.
Deşifre ve kulak eğitimi hafızadan ayrılamaz. Müzik öğrenme sürecinde deşifre ve kulak eğitimi çok önemli bir beceridir. Deşifre-şarkı kulak eğitiminin amacı, öğrencilerin belirli notaları dinleyerek ve söyleyerek müzik becerilerini ve hafızalarını geliştirmelerine olanak sağlamaktır.
Deşifre-şarkı kulak eğitiminin ana içeriği perde, ritim, ses, melodi, armoni vb. içerir. Deşifre-şarkı kulak eğitimi sayesinde, kulaklarımızı sürekli olarak çalıştırabiliriz, bu da çeşitli notaları ve ritimleri daha doğru bir şekilde tanımlamamızı ve hızlı bir şekilde dönüştürmemizi sağlar. duyduğumuz notaları müzik haritasındaki sembollere dönüştürür, böylece hatırlama yeteneğimizi geliştirir.
Deşifre ve kulak eğitimi aynı zamanda müziğin yasalarını daha iyi anlamamıza ve bunlara hakim olmamıza da yardımcı olabilir. Müziği doğrudan hissetmek ve anlamak için kulaklarımızı kullandığımızda müziğin ritmini ve melodisini daha derinlemesine anlayabilir, böylece hafıza yeteneğimizi daha hızlı geliştirebiliriz.
Ayrıca deşifre ve kulak eğitimi de iyi bir müzik anlayışı ve güçlü müzikal duygular geliştirmemize yardımcı olabilir. Eğitim sayesinde müzik anlayışımız ve duygularımız giderek derinleşecek, müzik sevgimiz ve takdirimiz artacaktır.
Bellek, müzik öğrenme sürecinde çok önemli bir faktördür. İyi hafıza becerileri, herhangi bir enstrümanı öğrenmek ve müzik bestelemek için gerekli koşullardan biridir. Deşifre ve kulak eğitimi yoluyla hafızamızı geliştirebilir ve müzik teknikleri ve becerilerinde daha iyi ustalaşabiliriz. Karmaşık bir repertuarla karşılaştığımızda notaları ve ritimleri daha hızlı hatırlayabiliriz, bu da müzik eserlerini daha iyi icra etmemize yardımcı olur.
Kısacası, deşifre eden kulak eğitimi ve hafıza birbirinden ayrılamaz ve ikisi birbirini tamamlar. Sürekli deşifre etme ve kulak eğitimi eğitimi sayesinde müzik becerilerimizi ve hafıza yeteneklerimizi geliştirerek müzikte daha iyi ustalaşabiliriz. Belleği geliştirmemiz gerektiği görülebilir ve Cistanche Deserticola hafızayı önemli ölçüde geliştirebilir çünkü Cistanche Deserticola, birçok benzersiz etkiye sahip olan geleneksel bir Çin tıbbi malzemesidir ve bunlardan biri hafızayı geliştirmektir. Kıymanın etkinliği içerdiği asit, polisakkaritler, flavonoidler vb. gibi çeşitli aktif bileşenlerden gelir. Bu bileşenler beyin sağlığını çeşitli şekillerde geliştirebilir.

Beyin fonksiyonunu iyileştirmenin yollarını bilin'e tıklayın
İlk olarak, orijinal sesi işlemek ve karşılık gelen özellikleri çıkarmak için Mel frekansı cepstrum numarası kullanılır. tr, derin öğrenme alanındaki YOLO-v4 modelini ses tanıma alanına uygulamaya çalışın ve farklı ses formatlarındaki verilerin genelleme yeteneğini güçlendirmek için uzaysal piramit havuz modülüyle birleştirerek geliştirin. İkincisi, topluluk öğrenmede istifleme yöntemi, iki farklı kanalın bağımsız alt modellerini birleştirmek için kullanılır. Deneysel sonuçlar, geliştirilmiş YOLO-v4 modelinin diğer derin öğrenme teknolojileriyle karşılaştırıldığında ses tanıma performansını artırabildiğini ve farklı ses formatlarındaki verileri işlemede daha iyi performansa sahip olduğunu ve bunun da daha iyi genelleme yeteneği gösterdiğini göstermektedir.
1. Giriş
Müzik, sesin ifade aracı olduğu soyut bir sanat formudur. Müzik öğretimi sürecinde solfej, öğrencilerin müzikal hafıza yeteneğini güçlendirebilir, öğrencilerin müzik eserlerini doğru bir şekilde tanımlamalarını sağlayabilir ve böylece daha iyi bir "müzikal algı" elde edebilir. Solfejde önemli bir halka olan ses tanıma eğitimi, üçüncü sınıf öğrencileri için oldukça zordur. Bunun nedeni, öğrencilerin her türlü nota anahtarına hakim olmaları, farklı notaların temsil ettiği uzunluk ve süreyi ve farklı notalar arasındaki perde farkını ayırt etmeleri gerektiğidir.
Gömülü akıllı cihazlara dayalı ses sinyali analizi giderek daha fazla araştırmacının ilgisini çekmektedir [1-7]. Ses tanıma işlevlerine sahip akıllı giyilebilir cihazlar, öğrencilerin yukarıdaki sorunları çözmelerine ve müzik öğretimi yardımını gerçekleştirmelerine yardımcı olabilir. Ses tanıma görevinin, toplanan ses sinyallerini ön işlemesi, dinlenmesi, müzik notalarını onlardan ayırt etmek için değerli özellikleri çıkarması ve ...son olarak bunları bu özelliklere göre sınıflandırması gerekir. Sınıflandırma, veri madenciliğinin çok önemli bir yöntemidir [8–10]. Sınıflandırma, eğitim seti verilerine dayalı olarak belirli kurallara göre bir klasikleştirme fonksiyonunun oluşturulması anlamına gelir. Bu işlev, test kümesinin verilerini verilen kategorilerden birine eşleyebilir, böylece bilinmeyen verilerin kategori tahminini gerçekleştirebilir. Şu anda yaygın klasikler arasında karar ağaçları, lojistik regresyon, destek vektör makinesi (SVM), Naive Bayes, k-en yakın komşu algoritması (KNN), BP sinir ağı ve derin öğrenme yer almaktadır [11-13].
Önceki makine öğrenimi yöntemlerinin genellikle, sınıflandırıcının girişi olarak orijinal verileri temsil edebilen özellikleri manuel olarak çıkarması gerekir. Bununla birlikte, girdi verileri orijinal verinin bilgilerini mümkün olduğunca kapsadığı sürece derin öğrenme, örneklerin yüksek boyutlu özelliklerini (manuel özellik çıkarımı olmadan) otomatik olarak çıkarabilir; bu da büyük ölçekli veriler için uygundur. *Derin öğrenme yöntemi, akıllı cihazlar tarafından toplanan büyük miktarda ses verisinin yardımıyla belirli ses tanıma görevlerini gerçekleştirebilir. *e evrişimsel sinir ağı (CNN), bir tür derin öğrenme mimarisi olarak, yerel özellik öğrenmedeki üstün performansı nedeniyle görüntü sınıflandırma, konuşma tanıma, doğal dil işleme ve diğer alanlarda yaygın olarak kullanılmaktadır [14]. Diğer sinir ağı modellerinden (Boltzmann makinesi ve yinelenen sinir ağı gibi) farklı olarak CNN, çekirdek işleminin evrişim işlemi olmasıyla karakterize edilir. *e YOLO ağı, CNN sınıflandırma ağ yapısından dersler çıkarır ve birçok araştırmacının dikkatini çeken görüntü tanıma alanında iyi avantajlar gösterir.
*Bu nedenle, bu çalışma YOLO-v4 modelini ses tanıma alanına uygulamaya ve ağ yapısını geliştirmeye çalışmaktadır. Ayrıca topluluk öğrenmede istifleme yöntemi, farklı kanalların iki bağımsız alt modelini birleştirmek için kullanılır ve birleştirilmiş sistemin sınıflandırma performansı, tekli alt modele kıyasla daha da iyileştirilir.
2. İlgili Çalışmalar
Günümüzde çok sayıda akıllı cihazın ortaya çıkmasıyla birlikte mükemmel bilgisayar performansı ve derin öğrenme teknolojisinin gelişmesi, ses alanındaki araştırma sürecini birlikte teşvik etmiştir. Bu çalışmanın ana araştırma içerikleriyle birleştirildiğinde, mevcut araştırma durumu iki açıdan tanıtılacaktır: evrişimli sinir ağı ve ses tanıma.
*e evrişimli sinir ağı yapısı, 1998 yılında Yann LeCun tarafından Le Net-5 yapay sinir ağı adı verilen bir çalışmadan kaynaklanmıştır. *Evrişimli sinir ağı, diğer sinir ağları gibi, geri yayılım algoritması ile eğitilebilmektedir [15]. 2012 yılında Alex Krizhevsky ve diğerleri, karmaşık bilgisayarlı görme görevlerinde ilk kez CNN teknolojisini benimsedi. 3 tam bağlantılı katman, 5 evrişim katmanı ve Softmax sınıflandırıcı kullanılarak AlexNet adı verilen 8 katmanlı bir evrişimli sinir ağı oluşturulmuştur. AlexNet, ReLU aktivasyon fonksiyonunu kullanır ve aynı zamanda aşırı uyumu önlemek için düzenlileştirmeyi (bırakma) da kullanır. 2014 yılında, Google görüntü işleme ekibi, yeni bir yapı olan olay içeren, 22 katmanlı ağ derinliğine sahip GoogLeNet ağını [16] öne sürdü. Farklı derinliklerin ve aynı ölçeğin özelliklerini entegre eder ve algılama doğruluğu geliştirilir. GoogLeNet ağını temel alan YOLO ve SSD algoritmaları ortaya çıktı. Her iki yöntem de, orijinal görüntüden nesne konumu ve kategorisinin çıkışına kadar girişi tamamlayabilen tek bir uçtan uca ağa dayanmaktadır.
Ses tanıma açısından Yang ve Zhao [17], sınıflandırma doğruluğunu geliştirmek için ses dokusunu geliştiren destek vektör makinesine (SVM) dayalı bir akustik sahne sınıflandırma yöntemi önerdiler. Greco ve ark. [18] sezgisel derin öğrenme yöntemini temel alan bir ses tanıma sistemi önerdiler. Demir ve ark. [19] çevresel ses sınıflandırması için yeni bir piramit basamaklı CNN yöntemi önerdi. Zhu ve diğerleri. [20], ses görüntüleme cihazları için akustik faz bulutu görüntü algılamasının doğruluğunu etkili bir şekilde artıran geliştirilmiş bir YOLO-v4 algoritması önerdi. *Yukarıdaki yöntemlerin tümü, tek bir akustik sahnede ses tanıma görevleriyle başa çıkmada mükemmel performans gösterir, ancak müzik öğretimi ortamında birçok ses bozukluğu vardır ve çeşitli farklı ses formatı verileriyle uğraşmak gerekir.
*Bu nedenle bu çalışma, geliştirilmiş YOLO-v4 ağ modelini temel alan bir ses tanıma sistemi önermektedir. *E ana yenilikler ve katkılar şunları içerir: (1) derin öğrenme alanında mükemmel olan YOLO-v4 ağ mimarisini ses tanıma alanına uygulamaya çalışın ve uzamsal piramit havuz modülünü birleştirerek onu geliştirin. *e geliştirilmiş YOLO-v4 ağ mimarisi, ses dosyalarındaki uzamsal bilgileri etkili bir şekilde kullanır, böylece farklı ses formatlarındaki verilerin genelleme yeteneğini güçlendirir. (2) Topluluk öğrenmede *e istifleme yöntemi, farklı kanalların iki bağımsız alt modelini birleştirmek için kullanılır ve birleştirilmiş sistemin sınıflandırma performansı iyileştirilir.
3. Ses Özelliklerinin Çıkarılması ve İşlenmesi
Ses sinyalinin en iyi parametre gösterimini çıkarmak, daha iyi tanıma performansı elde etmek için önemli görevlerden biridir. *Bu aşamada öznitelik çıkarımı, bir sonraki aşamadaki sınıflandırıcı sınıflandırması için oldukça önemlidir çünkü sınıflandırma verimliliğini doğrudan etkileyecektir.
Sınıflandırma görevinde, özellikle de ses sınıflandırma görevinde, spektral şekli tanımlayan Mel frekansı cepstrum katsayısının (MFCC) uzun bir geçmişi vardır. MFCC çıkarma işlemi verinin kayıplı sıkıştırılmasına neden olsa da sınıflandırma ve tanıma etkisi veri hızı çok düşük olduğunda bile oldukça mevcuttur. Ayrıca diğer sınıflandırma özellikleriyle karşılaştırıldığında MFCC, insan kulağının işitsel frekans tepki eğrisiyle daha uyumlu olduğundan yaygın olarak kullanılmaktadır.

*İnsanoğlunun karmaşık ses ortamlarında farklı ortamları değerlendirebilmesinin nedeni kokleanın takdirinde yatmaktadır. *koklea, insanların 20-20 kHz sesi filtrelemesine yardımcı olacak bir filtre bankası olarak görülebilir. *Sorun, kokleanın işitsel aralıktaki frekanslara duyarlılığının doğrusal olmaması, ancak bir haritalama ilişkisinin olmasıdır. MFCC, insan kulağının frekans tepkisini simüle edebilir. MFCC özellik çıkarımı yedi adımdan oluşur ve tüm süreç Şekil 1'de gösterilmektedir.
Yaygın ses sinyalleri, düşük frekanslı enerjinin büyük, ancak yüksek frekanslı enerjinin küçük olduğu olgusuna sahiptir. Doğrudan iletilmesi durumunda, düşük frekanslarda yüksek sinyal-gürültü oranına, yüksek frekanslarda ise yetersiz sinyal-gürültü oranına yol açacaktır. İletim sırasındaki bu ses sinyali kaybını telafi etmek için, giriş sinyalini telafi etmek üzere ön vurgu uygulanır, böylece ses sinyalinin yüksek frekans özellikleri vurgulanabilir. Ön vurgu genellikle yüksek geçişli bir filtre kullanılarak elde edilir [21-23].

Çerçeveleme, analogdan dijitale dönüştürmeden (ADC) elde edilen ses örneklerini 20-40 milisaniye aralığında uzunluktaki küçük karelere böler. Ön vurgu ve çerçeveleme tamamlandıktan sonra her çerçeveye bir Hamming penceresi eklemek gerekir. Pencereleme, veri işleme miktarını kontrol etmek içindir ve aynı anda yalnızca penceredeki veriler işlenir. * Hızlı Fourier dönüşümü spektrumundaki frekans aralığı çok geniştir, bu da konuşma sinyalinin doğrusal ölçeği takip etmemesine yol açar [24-26]. *bu nedenle Şekil 2'de gösterildiği gibi Mel ölçekli filtre bankasından geçmek gerekir.
Şekil 2, işlenen çıktının Mel ölçeğine yaklaşması için filtrelerin spektral bileşenlerinin ağırlıklı toplamını hesaplamak için kullanılan bir dizi üçgen filtreyi göstermektedir. * Her filtrenin genlik-frekans yanıtı üçgen şeklindedir. *e Belirli bir frekans f'nin Mel spektrumu aşağıdaki şekilde hesaplanır:
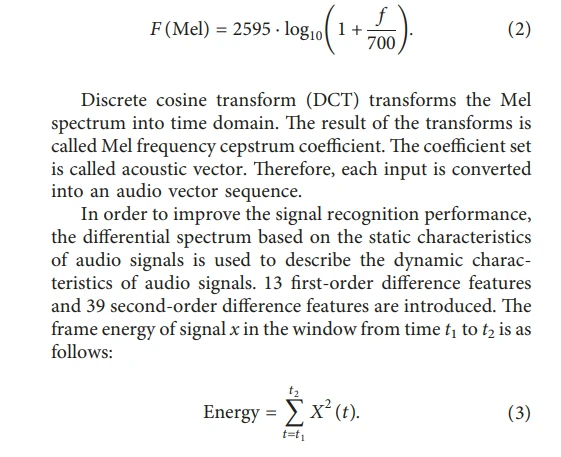
13 birinci dereceden diferansiyel özellik, MFCC özelliklerinde cepstrum çerçeveleri arasındaki değişiklikleri temsil ederken, 39 ikinci dereceden diferansiyel özellik, birinci dereceden diferansiyel özelliklerde çerçeveler arasındaki değişiklikleri temsil etmektedir. *e birinci dereceden fark aşağıdaki şekilde hesaplanır:

4. SPP-YOLO-v4 Ağ Yapısı
4.1. Uzamsal Piramit Havuzu (SPP) Modülü. SPP, ölçeklendirme, uzatma, kırpma ve diğer işlemlerden kaynaklanan bilgi bozulmasını önleyebilir ve kayan pencere havuzu teknolojisiyle elde edilemeyen girdi boyutundan etkilenmeyen çıktı sağlayabilir [27]. İkincisi, SPP birden fazla ölçekle havuz oluşturabilir, kayan pencere havuzunda ise yalnızca bir pencere ölçeği kullanılır. *SPP modülünün temel yapısı Şekil 3'te gösterilmektedir. Giriş boyutunun esnek olması nedeniyle SPP'nin farklı ses formatlarındaki verilerin özelliklerini birleştirebildiği görülmektedir. *Dönüştürülen özellik vektörünün e boyutu, genelleme sorununu hafifletirken, tamamen bağlı katmanın boyutuyla aynıdır.
4.2. SPP-YOLO-v4. YOLO-v4, YOLO-v1, YOLO-v2 ve YOLO-v3'ü entegre eden yüksek hassasiyetli, gerçek zamanlı, tek aşamalı bir algılama algoritmasıdır. YOLO-v4, özellik katmanının giriş olduğu ve daha yüksek katmanın özellik bilgilerinin çıkış olduğu artık modülde CSP çapraz aşama kısmi ağını (CSPNet) oluşturur. *ResNet modülündeki YOLO-v4'ün öğrenme hedeflerinin çıktı ve girdi arasında farklı olduğunu gösterir. *Bu nedenle artık öğrenme gerçekleştirilir ve model parametreleri azaltılır, böylece özellik öğrenme yeteneği artar. Müzik öğretiminin uygulama ortamı dikkate alınarak orijinal ağ baz alınarak bazı değişiklikler yapılmış olup, son ağ yapısı Şekil 4'te gösterilmiştir.
Öncelikle özellik katmanı üç kez evrilir ve daha sonra giriş özellik katmanı, farklı boyutlardaki maksimum havuzlanmış çekirdekler kullanılarak maksimum şekilde havuzlanır. Evrişim ve üst örneklemeden sonra, özellik füzyonunu gerçekleştirmek için farklı özellik katmanları seri olarak bağlanır. *tr, alt örnekleme gerçekleştirin, yüksekliği ve genişliği sıkıştırın ve son olarak daha fazla özellik füzyonu gerçekleştirmek için (5 kez) önceki özellik katmanıyla istifleyin. *Sınıflandırma modülü, sınıflandırma kararları vermek için ağdan çıkarılan özellikleri kullanır. Örnek olarak 13 ×13 ızgarayı alın; bu, giriş Mel spektrogramını 13 ×13 karelere bölmeye eşittir; daha sonra her kareye üç önceki kare önceden ayarlanacaktır. * Ağın sınıflandırma sonuçları, bu üç önceki kutunun konumlarını ayarlayacak ve son olarak nihai sınıflandırma sonuçlarını elde etmek için maksimum olmayan bastırma (NMS) algoritması [28] tarafından filtrelenecektir.

5. SPPYOLO-v4 Tabanlı Ses Tanıma Sistemi
5.1. Sistem mimarisi. Şekil 5'te gösterildiği gibi, ses girişinden sonra önerilen ses tanıma sistemi öncelikle ses dizisi verilerini iki parçaya böler. *İlk bölüm stereo kanaldan gelir, ikinci bölüm ise mono olarak sıkıştırılır. *İki kanalın ses sinyalleri MFCC spektrogramı tarafından çıkarılır ve özellik olarak SPP-YOLO-v4 modeline girilir. *tr, iki grup SPP-YOLO-v4 modeli entegre edilmiştir ve entegrasyonda istifleme yöntemi benimsenmiştir. İki modelin entegre öğreniminden sonra ses sınıflandırma sonuçları nihayet çıktı olarak verilir. *SPP-YOLO-v4 modelinin detayları Şekil 4'te gösterilmektedir.
5.2. Entegre Öğrenmeyi Yığınlama. Şekil 5'te gösterildiği gibi sistem, nihai sınıflandırma sonucunu elde etmek için topluluk öğrenme teknolojisini kullanır. *Topluluk öğrenmenin temel fikri, birkaç zayıf sınıflandırıcının birleşimi yoluyla güçlü bir sınıflandırıcı oluşturmaktır. Bazı zayıf sınıflandırıcılar yanlış tahminlerde bulunsalar bile, doğru tahmin yapan diğer zayıf sınıflandırıcılar tarafından düzeltilerek sistemin performansını iyileştirme etkisi elde edilebilir.
X'in girdi olduğunu varsayarsak, mi (i 1, 2, . . , k) bir sınıflandırıcı grubudur ve sınıflandırıcıların çıkışı, her bir cj (i 1, 1, ) sınıfının olasılık dağılımı mi (x, cj)'dir. 2, . . . , k), entegre sınıflandırıcının son çıktısı y(x) şu şekilde ifade edilebilir:


sınıflandırma hedefi Şu anda popüler topluluk öğrenme algoritmaları istifleme, torbalama, güçlendirme, topluluk seçimi vb.'yi içerir. *Bu çalışmada seçilen topluluk öğrenme algoritması istifleme yöntemidir.
Yığınlama, "meta-öğrenme" olarak da bilinen, birinci dereceden öğrenme sürecinin çıktısının girdi olduğu ikinci dereceden bir öğrenme sürecidir. *Yığınlama yöntemi, yalnızca uygulamasının oldukça basit olması nedeniyle değil, aynı zamanda bu çalışmanın amacı ile oldukça tutarlı olan sistemin genelleme yeteneğini önemli ölçüde geliştirebilmesi nedeniyle popüler bir topluluk öğrenme yöntemi haline gelmiştir. *İstifleme yönteminin temel prensibi Şekil 6'da gösterilmektedir.
6. Deney ve Sonuç Analizi
6.1. Deneysel Ortam ve Veri Kümesi. *Bu çalışmanın donanım platformu Intel Core i3-M350 CPU@ Dualcore 2,20 GHz, 8 GB DDR2 bellek, Nvidia RTX2080Ti GPU ve 11 GB video belleğidir. *e PyCharm entegre geliştirme aracı Python 3.5.0 dilinde geliştirilmiştir. *e Python'da yazılmış YOLO açıklama çerçevesi, sayısal formatı YOLO tarafından okunabilecek şekilde dönüştürmek için kullanılır. *karşılaştırma yöntemleri Gauss karışım modeli (GMM), CNN ve R-CNN'dir.

*e deneysel veri seti gerçek öğretim ortamında kaydedilen ses dosyalarından oluşur. *e veri seti dört farklı etiketin (D1, D2, D3 ve D4) ses türlerinden oluşur. Tüm ses dosyaları 30-ikinci kliplere kesilir. *MPEG, MP3 ve WMA dahil 12 ses dosyası formatı vardır. Her kayıt farklı bir yerde gerçekleştirilir ve ortalama kayıt süresi 3-5 dakikadır. *e kayıt ekipmanı, iki kanallı Soundman OKM II Classic/stüdyo A3 kulak içi mikrofonu ve 44,1 kHz örnekleme hızına ve 24-bit çözünürlüğüne sahip Roland Edirol R09 dalga biçimi kaydediciyi içerir.
*Kullanılan veri seti 1404 ses dosyası içermektedir ve her türden ses dosyası sayısı 351'dir. Verilerin yaklaşık %70'i ses tanıma modelinin eğitimi için, geri kalan %30'u ise test için kullanılır. *e sistem ayarları Tablo 1'de verilmiştir.


6.3. SPP-YOLO-v4 Performansının Doğrulanması. Önerilen geliştirilmiş YOLO-v4'ün (SPP-YOLO-v4) genelleme yeteneği üzerindeki teşvik etkisini doğrulamak için geleneksel YOLO-v4 modeliyle karşılaştırılmıştır. Deneyde 12 ses dosyası formatından 3'ü seçildi: MPEG, MP3 ve WMA. *SPP-YOLOv4'ün genelleme yeteneği Tablo 2'de verilmiştir.
Tablo 2'den SPP-YOLO-v4'ün genel doğruluğunun geleneksel YOLO-v4'ünkinden daha yüksek olduğu bulunabilir; bu da onun farklı ses formatlarındaki veriler için genelleme yeteneğini doğrular. *çünkü orijinal yöntemle karşılaştırıldığında SPP-YOLO-v4'ün SPP'si daha fazla katman içerir ancak aynı zamanda işlem süresini de arttırır.
6.4. Test Sonuçlarının Karşılaştırılması. Tablo 3, 8000 eğitim turundan sonra tüm kategoriler için eğitim kaybı, mAP vb. sonuçlarını sağlar. Önerilen yöntemin eğitim modelinin ses türlerini etkili bir şekilde tanımlayabildiği görülmektedir. Doğruluk, geri çağırma oranı ve F1 puanı açısından belirli avantajlara sahiptir ve kayıp değeri de tüm yöntemler arasında en düşük değer olan yalnızca 0,0122'dir. *Dolayısıyla önerilen yöntemin kararlılığı ve doğruluğu daha iyidir. *esas olarak SPP-YOLO-v4'ün yüksek çözünürlüğü ve alıcı alanından (RF) kaynaklanmaktadır ve bağlantı katmanına SPP modülünün eklenmesi, SPP'nin getirdiği avantajları korur. Eğitim süresi açısından SPP-YOLO-v4, GMM'den yalnızca biraz daha fazladır. *e CNN'in çok sayıda evrişim işlemini eğitmesi gerekir, bu nedenle eğitim süresi daha uzundur.

Son olarak deney, dört yöntemi test etmek ve karşılaştırmak için 12 farklı ses formatından gelen verileri kullanır. Tablo 4'te test doğruluğu ve test süresi değerleri verilmektedir. Bu çalışmada önerilen yöntemin ortalama doğruluğunun %99.0, ortalama tespit süresinin ise 0.449ss olduğu görülmektedir. *Dolayısıyla önerilen yöntem, karşılaştırılan dört yöntem arasında daha iyi performans elde etmektedir. SPP-YOLO-v4'ün üst örneklemesinin ve maksimum havuzda toplanmasının önemli faydalar sağladığı sonucuna varılabilir. Maksimum havuzlama, ses dizisindeki bazı maksimum frekans gürültülerini hafifçe silmek için bitişik alanlardan maksimum değeri seçer. *Bu nedenle, evrişim alt örneklemesi sonraki örnekleme katmanında daha iyi çalıştırılabilir. *Bu avantajlar sayesinde SPP, omurga ağının performansını artırabilir.

7. Sonuçlar
*Çalışma müzik öğretim ortamına uygun bir ses tanıma sistemi sunmaktadır. YOLO-v4 ağ mimarisini geliştirmek için SPP'yi kullanın; yani, çok ölçekli sistemin özelliklerini öğrenmek amacıyla aynı evrişim katmanının farklı ölçeklerindeki yerel alanları seçmek için SPP'yi kullanın. Ayrıca topluluk öğrenmede istifleme yöntemi, iki farklı kanalın bağımsız alt modellerini birleştirmek için kullanılır. *Deneysel sonuçlar, önerilen yöntemin ses türlerinin tanıma doğruluğunu artırabildiğini ve farklı ses dosyası formatları için daha iyi performansa sahip olduğunu göstermektedir. Ses kayıt koşullarının sınırlı olması nedeniyle deneysel veri setinde az sayıda ses türü bulunmaktadır ve farklı cihazlarla kaydedilen ses dosyalarının sınıflandırma performansı henüz doğrulanmamıştır. Gelecekte bu iki konu üzerinde daha fazla test yapılacak.
Veri kullanılabilirliği
*Bu çalışmanın bulgularını desteklemek için kullanılan veriler talep üzerine ilgili yazardan temin edilebilir.
Çıkar çatışmaları
*Yazarlar herhangi bir çıkar çatışmasının olmadığını beyan ederler.
Referanslar
[1] S. Wu, D. Zhang, Z. Zhang, N. Yang, M. Li ve M. Zhou, "Dependency-to-Dependency nöral makine çevirisi", Ses, Konuşma ve Dilde IEEE/ACM İşlemleri İşleme, cilt. 26, hayır. 11, s. 2132–2141, 2018.
[2] J. Zou, W. Li, C. Chen ve Q. Du, "İşbirlikçi temsil füzyonu ile yerel ve küresel özellikleri kullanan sahne sınıflandırması", Information Sciences, cilt. 348, hayır. 2, s. 209–226, 2016.
[3] H. Phan, L. Hertel, M. Maass, P. Koch, R. Mazur ve A. Mertins, "Etiket ağacı yerleştirmelerine ve evrişimli sinir ağlarına dayalı geliştirilmiş ses sahnesi sınıflandırması", IEEE/ACM İşlemleri Ses, Konuşma ve Dil İşleme, cilt. 25, hayır. 6, s. 1278–1290, 2017.
[4] S. Bayatlı, "Maksimum entropi yaklaşımı kullanılarak kural tabanlı makine çevirisinde transfer kurallarının denetimsiz ağırlıklandırılması", Bilgi Bilimi ve Mühendisliği Dergisi, cilt. 36, hayır. 2, s. 309–322, 2020.
[5] A. Rakotomamonjy, "Ses sahnesi sınıflandırması için denetimli temsil öğrenimi", Ses, Konuşma ve Dil İşleme Üzerine IEEE/ACM İşlemleri, cilt. 25, hayır. 6, s. 1253–1265, 2017.
[6] W. Yang ve S. Krishnan, "Akustik sahne sınıflandırması için zamansal özellikleri yerel ikili modelle birleştirmek", IEEE/ ACM Transactions on Audio, Speech, and Language Processing, cilt. 25, hayır. 6, s. 1315–1321, 2017.
[7] AS Dhanjal ve W. Singh, "Hint işaret diline çok dilli konuşma için otomatik bir makine çeviri sistemi", Multimedya Araçları ve Uygulamaları, cilt. 81, hayır. 3, s. 4283–4321, 2021.
[8] MA. Alamir, "Evrişimli sinir ağlarının ve farklı topluluk sınıflandırıcılarının geç füzyonunu kullanan yeni bir akustik sahne sınıflandırma modeli", Applied Acoustics, cilt. 172, hayır. 3, s. 112–122, 2020.
[9] JG Makin, DA Moses ve EF Chang, "Kortikal aktivitenin kodlayıcı-kod çözücü çerçevesiyle metne makine çevirisi", Nature Neuroscience, cilt. 23, hayır. 4, s. 575–582, 2020.
[10] S. Waldekar ve G. Saha, "İki seviyeli füzyon tabanlı akustik sahne sınıflandırması", Applied Acoustics, cilt. 170, hayır. 5, Makale Kimliği 107502, 2020.
For more information:1950477648nn@gmail.com