

AttentionMNIST: El Yazısı Sayı ve Alfabe Tanıma İçin Fare Tıklamasıyla Dikkat İzleme Veri Seti
Feb 22, 2024
Nesneleri bir dizi bakışla tanıyan çok sayıda dikkat temelli model, el yazısı rakam tanıma konusunda sonuçlar bildirdi. Ancak el yazısı rakam veya alfabe tanımaya yönelik dikkat izleme verileri mevcut değildir. Bu tür verilerin mevcudiyeti, dikkat temelli modellerin insan performansıyla karşılaştırmalı olarak değerlendirilmesine olanak tanıyacaktır. Sıralı örnekleme yoluyla resimlerdeki el yazısıyla yazılmış rakamları ve alfabeleri (büyük ve küçük harfler) tanımaya çalışan 382 katılımcıdan fare tıklamasıyla dikkat izleme verileri topluyoruz. Karşılaştırmalı veri kümelerinden elde edilen görüntüler uyaran olarak sunulmaktadır. AttentionMNIST adı verilen toplanan veri seti, bir dizi örnek (fare tıklaması) konumlardan oluşur, prher örneklemede belirlenen sınıf etiketleri ve her örneklemenin süresi. Katılımcılarımız ortalama olarak bir görüntünün yalnızca %12,8'ini tanınma amacıyla gözlemliyor. Bir katılımcının bir sonraki örneklemede seçeceği konumu ve sınıf(lar)ı tahmin etmek için bir temel model öneriyoruz. Katılımcılarımızla aynı uyaranlara ve deneysel koşullara maruz kaldığında, çokça alıntı yapılan dikkat temelli pekiştirme modeli insan verimliliği konusunda yetersiz kalıyor.

Çin cistanche'sibitki- Alzheimer Hastalığı ürünlerini önleyin
Nesneleri bir dizi bakış yoluyla tanıyan makine öğrenimi (ML) modelleri, ölçeklenebilirlikleri ve verimlilikleri nedeniyle son yıllarda ilgi görmeye başlamıştır. Bu modellerin çoğu, örneğin 1-7, el yazısı rakam tanıma için MNIST veri seti karşılaştırmalı değerlendirmesinde deneysel sonuçlar rapor etmiştir. Ne yazık ki MNIST için dikkat izleme verisi mevcut değil. Bu durum dikkat temelli modellerin insan performansına göre değerlendirilmesini engellemektedir. Sıralı örnekleme yoluyla resimlerdeki el yazısıyla yazılmış rakamları ve alfabeleri tanımaya çalışan yetişkin katılımcılardan bir veri seti toplayarak bu boşluğa düştük. Göz hareketi dikkat takibinin (emAT) aksine, katılımcı görüntüde görmek istediği konuma tıklar (bir tür fare tıklamasıyla dikkat takibi (mcAT)). Hemen ardından o ana kadar yaptığı gözlemlere dayanarak nesnenin ait olabileceğini tahmin ettiği sınıf(lar)ı seçer. Böylece, her örnekleme bölümünde verilerimiz seçilen görüntü konumundan, tahmin edilen sınıf etiketinden/etiketlerinden ve katılımcı tarafından son bölümden bu yana geçen süreden oluşur. Her görüntüden sonra katılımcı performansına (doğruluk ve verimlilik) bağlı olarak bir ödül alır.
Cistanche tubulosa'nın faydaları-Anti Alzheimer hastalığı
El yazısı rakam/alfabe tanıma konusunda mcAT'ın emAT'a göre avantajları.
(1) et, özellikle statik uyaranlar (görüntüler)8,9 için sabitleme konumunda önemli kişisel ve kişiler arası değişkenlik içerir. Dolayısıyla istatistiksel olarak anlamlı sonuçlara ulaşmak için büyük miktarda göz sabitleme verisine ihtiyaç vardır. mcAT, göz izleme verilerinde yaygın olan bazı teknik gürültü kaynaklarından etkilenmez10. (2) Göz hareketleri hem istemli hem de istemsiz mekanizmalardan kaynaklanabilir11. Göreve bağlı karar vermeyi kolaylaştırmak için katılımcılara yeterli zaman, bağlam ve pekiştirme sinyalleri sunuyoruz; bunlar aynı zamanda bir ML modeline de sunulabilir. (3) EmAT verilerinin kesinliği ve doğruluğu göz takip cihazına bağlıdır, mcAT verileri ise herhangi bir cihazdan bağımsızdır. (4) Kişinin göz hareketlerini sınıf seçimiyle senkronize etmesi zorlu bir iştir. Bunun üstesinden gelmek için bizim durumumuzda örnekleme yeri ve sınıf(lar) aynı bölümde seçiliyor. (5) Son olarak yöntemimiz, 12,13'te olduğu gibi maliyet ve zaman açısından verimli ve kolayca tekrarlanabilir olan Amazon Mechanical Turk (MTurk) kullanılarak veri toplanmasına olanak sağlar.
Katkılar.
382 katılımcıdan MTurk'u kullanarak AttentionMNIST adı verilen bir mcAT veri kümesi topluyoruz; bu veri seti, sıralı örnekleme yoluyla resimlerdeki el yazısıyla yazılmış rakamları ve alfabeleri (büyük ve küçük harf) doğru ve verimli bir şekilde tanıdığı için ödüllendiriliyor. Karşılaştırma veri kümelerinden (MNIST, EMNIST) alınan görüntüler uyaran olarak sunulmaktadır. Ortalama olarak rakam/alfabe sınıfı başına 169,1 yanıt kaydedilir. Bu veri kümesini kullanarak aşağıdakileri gösteriyoruz: • Katılımcıların bir rakamı, büyük harf ve küçük harf alfabesini tanıması için ortalama olarak 4,2, 4,7 ve 4,9 örneğe ihtiyaç duyulmaktadır; bu da görüntü alanının sırasıyla yalnızca %11,3, %13,4 ve %13,7'sine karşılık gelir. . Sınıflandırma doğruluğu birden fazla örnekle artar. • Temel olarak sunulan bir model, bir katılımcının bir sonraki örnekleme bölümünde seçeceği sınıf(lar)ı ve konumu sırasıyla %74,4 ve %67,7 doğrulukla tahmin edebilir; her ikisinin de tüm örneklemeler ve veri kümeleri üzerinden ortalaması alınır. Örneklerin artmasıyla sınıf tahmin doğruluğu artar ve konum tahmin doğruluğu azalır. • Katılımcılarımızla aynı uyaranlara ve koşullara maruz kaldığında, yüksek oranda alıntı yapılan pekiştirmeye dayalı tekrarlayan dikkat modelinin (RAM)3 rakam, büyük harf ve küçük harf alfabesini tanıması için 3,7, 8,5 ve 7,6 örnek gerekir; bu da %8,9'a karşılık gelir , resim alanının sırasıyla %21,0, %18,7'si. Diğer dikkat temelli pekiştirme modelleri (örn. 1,2,4,5,7,14) insan performansıyla karşılaştırıldığında benzer şekilde değerlendirilebilir.

Yakınımdaki Cistanche takviyesi - Belleği İyileştirme
【Daha fazlasını isteyin】 E-posta:cindy.xue@wecistanche.com / Whats App: 0086 18599088692 / Wechat: 18599088692
Alakalı iş
McAT'deki fare tıklamalarının zamansal sırası, göz hareketi tarama yoluna10 benzer. mcAT, önemli ölçüde korelasyona sahip olduğundan emAT'nin yerini etkili bir şekilde alabilir10,12,13,15-17. mcAT çalışmalarında, canlı ve cansız nesnelerin görüntüleri10, doğal sahnelerin görüntüleri12,13, statik web sayfaları13, arama sayfası düzenleri16 ve görsel karşılaştırma için iki alfanümerik dizi listesi17 gibi farklı türde uyaranlar kullanılmıştır. Ancak mcAT, el yazısı rakam/alfabe sınıflandırma görevleri veya dikkat temelli sınıflandırma modellerinin değerlendirilmesi için kullanılmamıştır. mcAT çalışmaları, iletişim kurma süresi, ilgi alanlarındaki göreceli sabitleme sıklığı (AOI'ler), bir AOI'de en az bir kez tıklayan deneklerin göreceli oranı10, deneme başına sabitleme sayısı, denemeler içindeki yeniden sabitleme, bekleme süreleri ve tarama yolları17 gibi özellikleri kullanmıştır. , sabitleme haritaları12,13, AOI ve bilgi akış modeli16. Zaman damgalı tıklama konumları ve tahmin edilen sınıf etiketleri dizisi, sınıflandırma görevlerinde dikkat temelli modellerin veya insanların verimliliğini ve doğruluğunu değerlendirmek için gerekli ham verileri oluşturur. Bu verilerden farklı özellikler elde edilebilir. Göz izleme verilerine göre çok sayıda avantaja sahip mcAT veri kümemiz, yapay zeka, makine öğrenimi ve diğer alanlarda dikkat temelli model araştırmalarında önemli bir boşluğu dolduruyor. Veri setimiz dikkat temelli modellerin insan performansıyla karşılaştırmalı olarak değerlendirilmesine olanak tanıyacak. Diğer şeylerin yanı sıra bu, pratikte geniş kullanıma sahip olan verimli ve gerçek zamanlı optik karakter tanıma sistemlerinin geliştirilmesini kolaylaştıracaktır (örneğin bakınız 18-20). Görsel tespitlere rehberlik eden ilkeler, veri setimiz kullanılarak hipotez haline getirilebilir ve test edilebilir. Başarılı ilkeler, otonom sürüş gibi verimliliğin önemli bir konu olduğu gerçek dünyadaki görsel tanıma görevlerine yönelik sistemlerin geliştirilmesine aktarılabilir.
Veri
Verilerimiz her katılımcı için bir dizi T bölümünden oluşur. Her bölüme ilişkin veriler, (1) katılımcının görüntüde tıkladığı konum (bölüm başına görüntüye bir tıklama), (2) katılımcı tarafından seçilen sınıf(lar) ve (3) katılımcının görüntüde harcadığı zamandan oluşur. katılımcının geçerli örneği kaydetmesi (yani görüntüdeki son ve mevcut tıklamalar arasında geçen süre). Bu bölüm, uyaran seçimi, katılımcılar, görsel görevler, performans puanlaması ve veri filtreleme dahil olmak üzere veri toplama sürecimizi açıklayacaktır.
Uyaran seçimi. Uyaranlar iki kıyaslama veri kümesindeki görüntülerden seçilir: (1)
MNIST21 veri seti, el yazısıyla yazılan 10 sayıdan {0, 1, ..., 9} oluşan 70,000 etiketli görüntüden (28×28 piksel) oluşur. (2)
EMNIST22 veri seti, dengeli bir sınıf oluşturan, büyük ve küçük harflerle el yazısı İngilizce alfabelerden oluşan 145.600 görüntüden (28×28 piksel) oluşur. Tüm görseller 26 sınıftan (a, b, ..., z) biriyle etiketlenmiştir. Ancak büyük veya küçük harf etiketi herhangi bir görselle ilişkilendirilmemektedir. Her kategoriden, MNIST'ten 15 iyi biçimli rakam ve her biri EMNIST büyük harf ve EMNIST küçük harf veri kümelerinden 15 iyi biçimli alfabe seçiyoruz. İyi biçimlendirilmiş bir sayı veya alfabe, sınıfının normuna benzer. Böylece, 62 sınıfın her birine ait 15 görüntü içeren 15(10 + 26 + 26)=930 benzersiz görüntüden oluşan bir diziden uyaranlar sunuyoruz. İyi biçimlendirilmiş 930 görüntü aşağıdaki gibi seçilir:
Adım 1: Yoğunluğu 0 ile 1 arasında ölçeklendirmek için min-max kullanarak her görüntüyü normalleştirin.
Adım 2: İyi biçimlendirilmiş EMNIST görsellerini büyük veya küçük harfle etiketleyin. Her alfabe sınıfı için, hem büyük hem de küçük harflerden oluşan iyi biçimlendirilmiş bir alfabe manuel olarak seçilir ve etiketlenir. Bu sınıfa ait tüm görüntülerin etiketli iki görüntüyle kosinüs benzerliği hesaplanır. Kosinüs benzerliği eşiğinin üzerinde olan görüntülere (deneysel olarak 0.8 olarak seçilmiştir) büyük harf veya küçük harf etiketi atanır.
Adım 3: Her sınıfa ait görüntülerin ortalamasını hesaplayın. Bir sınıfın ortalama imajı onun normunu oluşturur. Bir görüntü, kendi sınıfının ortalama görüntüsüyle kosinüs benzerliği ampirik olarak belirlenen bir eşikten büyükse (MNIST için 0,7, EMNIST için 0,75) uyarıcı olmaya uygundur.
Adım 4: Uygun görseller arasından her sınıftan 15 görsel, ne kadar iyi biçimlendirildiklerine göre manuel olarak seçilir. Orijinal olarak 28×28 piksel olan her görüntü, yoğunluk değişimi olmadığından sınırlara yakın pikseller çıkarılarak 27×25 boyutuna düşürülür. Bu 15 görüntünün ortalaması 62 sınıfın her biri için hesaplanır. Bu ortalama görüntüleri her veri kümesindeki n sınıf için I1, I2, ..., In olarak belirtiyoruz.
Katılımcılar.
Çalışmamıza toplam 382 farklı yetişkin birey katılmıştır. Hiçbir seçim kriteri kullanılmadı. Bir katılımcı birden fazla resme yanıt verebilir. 62 sınıfın her biri için ortalama 169,1 yanıt kaydedildi.
Cistanche tubulosa'nın faydalarıAlzheimer hastalığına karşı
Görsel görev.
Görsel görevimiz için MTurk arayüzü Şekil 1'de gösterilmektedir. 270x250 boyutunda bir tuval, her zaman düşük yoğunluklu bir arka plan görüntüsü görüntüler. Arka plan ve uyarıcı görüntüler on kez 270×250 boyutuna örneklenir. Kanvasın merkezi, görüntülerin merkeziyle hizalanır. Arka Plan Başlangıçta arka plan, uyaranın alındığı veri kümesindeki tüm görüntülerin ortalamasıdır. İlk bölümden sonra arka plan, son bölümde katılımcı tarafından seçilen sınıf grubundaki tüm görüntülerin ortalamasıdır. Gerçek dünyada, bir sayının veya alfabenin konumu, boyutu ve yönüne ilişkin bağlam, burada eksik olan komşuluğundaki yazıdan elde edilir. Deneylerimiz boş bir arka planla gerçekleştirildiğinde, katılımcılar genellikle görüntünün nesnenin herhangi bir bölümünü içermeyen konumlarını örneklediler. Bu davranış, seçilen sınıf(lar)ın ortalama görüntüsünün düşük yoğunluklu bir arka planda sunulması ve tüm MNIST ve EMNIST görüntülerinin boyutunun 28x28 pikselden 27x25 piksele düşürülmesiyle kontrol altına alındı. Katılımcı tuval üzerinde bir konumu tıklatarak seçtiğinde, uyaran görüntüsünden o konumu ortalayan 50x50 piksellik bir yama ortaya çıkar. Bir kez ortaya çıkan yama, son bölüme kadar görüntülenmeye devam eder. Bir katılımcının görevi her t bölümünde (t=1, ..., T) üç adımdan oluşur:
Adım 1: Örneklemek istediği yamayı ortaya çıkarmak için 270×250 tuvalde herhangi bir yere tıklayın. Yalnızca ilk tıklama kabul edilir.
Adım 2: Şu ana kadar gözlemlenen tüm örneklerin rakamlarını/alfabelerini tanıyın. Katılımcı birden fazla sınıf seçebilir ve tuvalin altında gösterilen sınıf listesinden en az bir sınıf seçmelidir.
Adım 3: Devam etmek için ekranın altındaki "İleri"ye tıklayın. Sınıf hakkında doğru ve hızlı bir çıkarım yapmak için katılımcının mevcut bölüme kadar yaptığı gözlemlere göre yerleri dikkatli bir şekilde seçmesi gerekecektir. Bir bölüm için zaman sınırı yoktur. Ancak bir görüntünün T bölümünün toplam süresini altı dakikayla sınırlandırıyoruz. Dikkate dayalı el yazısı tanıma veya oluşturma konusunda yüksek oranda alıntı yapılan çalışmalar 12'den az bakış kullandığı için T=12'yi seçiyoruz (örneğin, RAM3, MNIST rakamlarını 7 bakışta tanıyabiliyor, DRAW23, 11 bakışta MNIST rakamlarını üretebiliyor) ve İnsanlar el yazısıyla yazılmış rakamları ve alfabeleri 12'den daha az bir bakışta tanıyabiliyor.
Performans puanlaması. Gözlemlenen örnek sayısı açısından doğruluğuna ve verimliliğine göre katılımcıya bir puan verilir. Herhangi bir bölümde seçtiği sınıflar kümesi olsun. On, t'deki puanı:

Şekil 1. MTurk arayüzümüzün bir katılımcı tarafından görülen hali. EMNIST büyük harf alfabesinin ikinci örneklemesi gösterilmektedir.
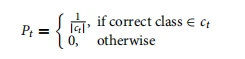
nerede |.| bir kümenin önem derecesini belirtir. T bölümde verilen toplam puan h {{0}} T t=1 Pt. Bu nedenle, her zaman yalnızca doğru sınıfı seçerse, T bölümlerde alabileceği maksimum puan T'dir. Her zaman doğru sınıfı içermeyen bir sınıf kümesi seçerse, T bölümde alabileceği minimum puan sıfırdır. Yani, 0 Küçük veya Eşit h'den Küçük veya Eşit T'ye. Katılımcı ne kadar erken doğru sınıfı seçerse puanı da o kadar yüksek olacaktır. Dolayısıyla bu puanlama mekanizması, tanıma doğruluğunu ve örnekleme verimliliğini hesaba katar. İlk bölümden yalnızca bir sınıf seçerek puanı en üst düzeye çıkarmaya çalışmak riskli olacaktır çünkü doğru sınıf değilse sıfır puan verilecek, katılımcı birden fazla sınıf seçerse sıfırdan büyük bir puan verilecektir ( doğru sınıfı içeren tüm sınıflar bile). Bu, katılımcıyı herhangi bir bölümde zihnindeki olası derslere göre yanıt vermeye motive edecektir. Her bölümde verilen puan, katılımcıya herhangi bir ipucu vermemek için yalnızca T bölümlerinin tamamlanmasından sonra açıklanır. MTurk'te katılımcının bir görsel için aldığı ücret, toplam puanı h ile orantılıdır.
Veri filtreleme.
Bir katılımcının bir uyarıcı görüntü için son (yani T-th) bölümdeki puanı sıfırsa, o görüntü için kaydedilen verileri atılır. Bir katılımcının görevi eksik bırakması durumunda da veriler silinir. Bu seçim kriteri ile MNIST'ten 1736, EMNIST büyük harften 4431, EMNIST küçük harften ise 4315 uyaran yanıtı elde ettik; yani sınıf başına ortalama 169,1 yanıt.
Verileri kullanmaya yönelik modeller ve yöntemler
Bu bölümde, (4.1) bir katılımcının davranışını tahmin etmek için bir temel model sağlayarak ve (4.2) mevcut bir dikkat temelli takviye modelinin insan rakamı/alfabe tanıma ile nasıl karşılaştırılabileceğini göstererek toplanan verilerin faydasını gösteriyoruz. verim. Davranış tahmininin temeli. Herhangi bir bölümdeki davranış, yer seçimi ve sınıf seçiminden oluşur. Bir örneklem farklı gözlemciler için, hatta aynı gözlemci için farklı zamanlarda9 farklı miktarda bilgi içerdiğinden, her katılımcının davranışını tahmin etmek zor bir problemdir. N, bir veri kümesindeki sınıfların sayısı olsun, ηt, t'deki uyaran görüntüsü için gerçek sınıfı içeren tekil küme olsun, ct, sınıfların kümesi olsun ve t'deki bir katılımcı tarafından gözlemi olarak seçilen konum olsun. t ve 1:t, 1, 2, ..., t dizisini belirtir. Herhangi bir t'ye kadar katılımcının gözlemleri o1:t ve seçtiği yerler l1:t'dir. Bir katılımcının davranış tahmini problemini şu şekilde formüle ediyoruz: Sınıf tahmini o1:t ve l1:t, yani P( göz önüne alındığında i∈ct (i=1, 2, ..., n) olasılığını tahmin edin. i ∈ ct|o1:t, l1:t). Konum tahmini o1:t, l1:t ve ct'ye göre lt+1 olasılığını tahmin edin, yani P(lt+1|o1:t, l1:t,ct). Sınıf tahmini. Bir katılımcının t bölümünde seçeceği sınıfı tahmin etmek için, katılımcının seçilmiş konumları l1:t ve buna karşılık gelen o1:t gözlemleri göz önüne alındığında, t'deki görüntü uyaranının sınıf I'e ait olma olasılığını aşağıdaki gibi hesaplıyoruz:
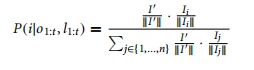
burada Ii, i sınıfına ait uyaran görüntülerinin (27×25) ortalamasıdır, I′ l1:t'de o1:t içeren 27×25 görüntüdür, · skaler çarpımı ve .Öklid normunu belirtir. Tüm piksel yoğunlukları negatif değildir. Herhangi bir t bölümünde, inanç dağılımı P(i|o1:t, l1:t)'den k en yüksek olası sınıflar, modelimiz tarafından tahmin edilen sınıflar kümesini oluşturur, ct, burada k=|ct|. Sınıflandırmanın doğruluğu Jaccard indeksi (JI) kullanılarak ölçülür. JI, X ve Y gibi iki küme arasındaki benzerliği şu şekilde ölçer: J(X, Y) {{10}} |X ∩ Y|/|X ∪ Y|. JI, 0 ile 1 arasında sınırlıdır; eğer X=Y, J(X, Y)=1. Herhangi bir t bölümünde, bir katılımcının sınıflandırma doğruluğu J(ηt,ct) iken modelimizin sınıflandırma doğruluğu J(ηt, ˆct)'tir. Paydasından dolayı JI, tahmin edilen kümedeki (ct veya ˆct) ηt'de olmayan elemanların sayısı arttıkça daha fazla cezalandırır ki bu bizim durumumuz için arzu edilen bir özelliktir. Bir katılımcının ve modelimizin sınıflandırması arasındaki benzerlik J(ct, ˆct) ile ölçülür. Modelimiz ayrıca her katılımcıya göre sınıf seçimi ve reddedilme doğruluğu açısından da değerlendirilmektedir. st=ct − ct−1 seçilen yeni sınıfların kümesi olsun ve rt=ct−1 − ct bir katılımcı tarafından t'de reddedilen sınıfların kümesi olsun. Benzer şekilde, ˆst=ˆct − ct−1 seçilen yeni sınıfların kümesidir ve ˆrt=ct−1 − ˆct, t'de modelimiz tarafından reddedilen sınıfların kümesidir. Daha sonra modelin sınıf seçimi ve reddedilmesi, |st| olduğunda J(st, ˆst) ile katılımcınınkiyle karşılaştırılabilir. > 0 ve J(rt, ˆrt) |rt| > 0 sırasıyla. Konum tahmini. Hipotez İdeal olarak, tüm sınıflar üzerindeki inanç dağılımı tek modlu (yani yalnızca bir tepe noktası) ve katılımcının uyaranın (çevrenin) sınıfı (durumu) konusunda kendinden emin olduğunu gösteren ince bir Gaussian (yani küçük standart sapma) olmalıdır. Bununla birlikte, verilerimizden açıkça görüldüğü gibi (bkz. Şekil 2), özellikle ilk birkaç bölüm sırasında bir katılımcının birden fazla sınıf arasında kafası karışır. Bu durumlarda, inanç dağılımının birden fazla zirvesi vardır veya kalın bir Gaussiandır. Bir katılımcının hedefinin, tek modlu ve ince bir Gaussian'a yakınlaşmak olduğunu varsayıyoruz; bunu başarmak için, biri hariç tüm sınıfların olasılığını azaltan konumları seçici olarak örnekliyor. Bu hipotez, göz hareketleri25 de dahil olmak üzere eyleme24 yön veren iyi bilinen bir prensip olan sınıflar (çevresel durumlar) üzerindeki belirsizliğin en aza indirilmesine yol açar.
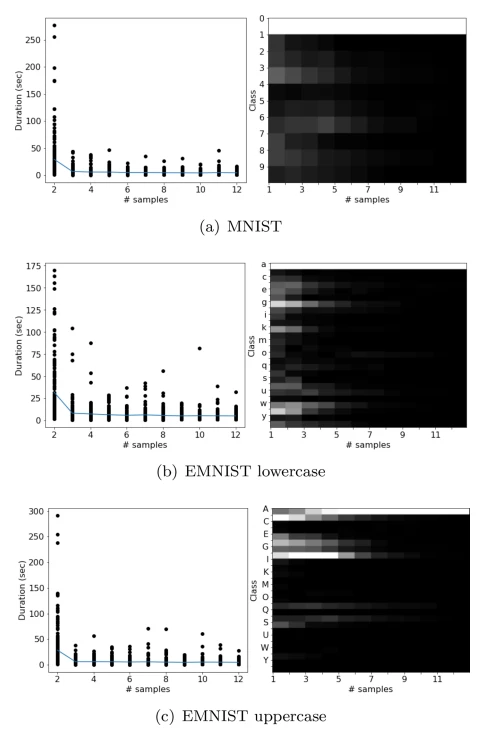
Şekil 2. '0', 'a' ve 'A' kategorilerine ait tüm katılımcılar ve uyaranlar üzerinde süre ve sınıf dağılımı.
Te observations at certain locations in a stimulus image can discriminate between certain classes. Te observation at a location l might indicate that the numeral/alphabet belongs to class I and not to class j. Such locations are more salient than others in achieving a participant's goal. To sample such locations, a saliency map, Dij, is computed such that if l is salient, the observation at l is evidence to increase the probability of class I and decrease that of j. Mathematically, Dij = N (., σ ) ∗ g(.), where ∗ is the convolution operator, g(.) is a saliency scoring function, and N (., σ ) is a 5×5 Gaussian kernel with standard deviation σ = 6 to smooth the saliency scores. We denote the set of all saliency maps as D = {Dij: i, j ∈ {1, 2, ..., n}, i �= j}. A location l in a stimulus image is salient for class i with respect to class j if Dij(l)>θ, burada eşik değeri θ=0.5 × max(D) ampirik olarak belirlenmiş bir skaler miktardır.
İki asimetrik metriği, Kullback-Leibler (KL) ıraksamasını ve farkını g fonksiyonu için aday olarak ele alıyoruz. KL ıraksaması Ii ve Ij normalize edilmiş iki ortalama görüntüsü verildiğinde, KL ıraksaması KL(Ii, Ij), Ii'ye yaklaşmak için Ij kullanıldığında bilgi kaybını ölçer. Bu, her k piksel için şu şekilde hesaplanır: KL(Ii,k, Ij,k)=Ii,k log δ + Ii,k Ij,k+δ, burada Ij,k, k'inci pikselin yoğunluğudur Ij'nin ve δ bir düzenleme sabitidir. Ii,k=Ij,k, KL(Ii,k,Ij,k) → 0 olduğunda. Fark İki normalleştirilmiş ortalama görüntü (Ii ve Ij) verildiğinde, her piksel k için fark Diff (Ii,k, Ij,k)=Ii,k − Ij,k'dir. When Ii,k=Ij,k, Diff (Ii,k, Ij,k)=0. Bir katılımcı mevcut bölümde seçtiği ders dizisinden (ct) emin değil. Bu nedenle, konum tahmini için yalnızca D'deki sınıfları içeren belirginlik haritalarını dikkate alıyoruz. Bir konum, bu belirginlik haritalarına göre belirginse ve katılımcı tarafından hiç seçilmemişse tahmin edilir. Böylece, o1:t, l1:t ve ct verildiğinde, lt+1 konumu aşağıdaki şekilde tahmin edilir:
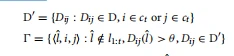
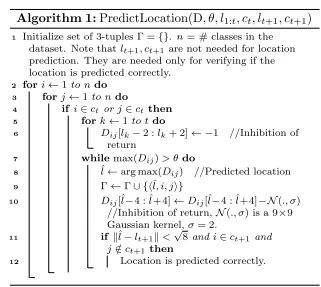
burada Ŵ, tahmin edilen ˆl konumunu, (i) için belirgin olduğu sınıfı ve hangi sınıfa (j) göre olduğunu içeren 3-demetler kümesidir. Eğer �ˆl − lt+1� < ϫ, I ∈ ct+1 ve j /∈ ct{{3} olacak şekilde bir �ˆl, i, j� ∈ Ŵ varsa, konum doğru şekilde tahmin edilir. }, burada ϫ, merkez piksel ile bir gözlem yamasındaki herhangi bir piksel arasındaki maksimum Öklid mesafesidir. Konum tahmini için sözde kod Algoritma 1'de gösterilmektedir. Sözde kodun ayrıntılı bir açıklaması ek materyalin S1 Bölümünde yer almaktadır. (Te olasılık dağılımı, P(lt+1|o1:t, l1:t,ct), Ŵ'de olmayan konumların belirginlik puanının sıfır olduğu varsayılarak ve ardından tümünün belirginlik puanı normalleştirilerek hesaplanabilir. konumların toplamı birliğe ulaşacaktır. Ancak Denklem (3) bu makalenin amaçları açısından yeterli olduğundan bu olasılık kullanılmamıştır.)
Dikkat temelli modellerin değerlendirilmesi.
Dikkat temelli modellerin bir temsilcisi olarak, MNIST veri seti üzerinde deneysel sonuçları raporlayan, çokça alıntılanan tekrarlayan dikkat modelini (RAM)3 ele alıyoruz. Bu güçlendirme modeli, bir görüntüyü sırayla örnekler ve her örnekleme anında bir sonraki nerede örnekleneceğine karar vererek, toplanan verileri kullanarak değerlendirmeye uygun hale getirir.
Veri deposu
görüntüleri bir dizi bakış kullanarak sınıflandırır. Bir sonraki konum, bir konum ağı tarafından parametrelendirilen bir dağılımdan stokastik olarak seçilir. Model, aşağıdaki hedefi maksimuma çıkararak uçtan uca eğitilir3:
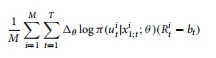
burada M bölüm sayısıdır, T gözlem sayısıdır, xi 1:t mevcut aracının I bölüme kadar çalıştırılmasıyla elde edilen etkileşim dizileridir, ui t mevcut eylemdir, θ eğitilebilir parametreler kümesidir, Ri t kümülatif ödüldür, bt bir temeldir ve π(ui t|xi 1:t; θ ) politikadır. RAM'in davranışı, RAM tarafından tahmin edilen konumların dizisinden ve katılımcılar tarafından seçilen konumlardan elde edilen sabitleme haritaları karşılaştırılarak katılımcıların davranışlarıyla karşılaştırılabilir. Bir sabitleme haritası, her konuma, seçim sıklığına eşit bir değer atanarak ve ardından bu değerlerin tüm konumlar üzerinde bir dağılım oluşturacak şekilde normalleştirilmesiyle hesaplanır.
Sabitleme haritalarını karşılaştırmaya yönelik ölçümler. İki sabitleme haritasını (P ve Q) karşılaştıran ölçümler için 26'yı yakından takip ediyoruz. Örnekleme konumlarının dağılımını karşılaştırmak için üç dağıtım tabanlı ölçüm kullanıyoruz: KL farklılığı (KL), Pearson korelasyon katsayısı (CC) ve Benzerlik (SIM). toplanan verilerde kayıtlı olan katılımcılardan alınan bir modelden.
KL (daha önce tanımlandı) sıfır değerlerine karşı oldukça duyarlıdır.
CC, iki harita arasındaki doğrusal ilişkiyi şu şekilde değerlendirebilir: CC(P, Q)=σ (P, Q) σ (P)σ (Q), burada σ varyans veya kovaryanstır. CC simetrik olduğundan, sabitleme haritaları arasındaki farkların yanlış pozitiflerden mi yoksa yanlış negatiflerden mi kaynaklandığı sonucunu çıkaramaz.
SIM 26 olarak ölçülür: SIM(P, Q)=k min(Pk, Qk), burada k Pk=k Qk=1. CC gibi SIM de simetriktir ve aynı dezavantajı taşır. Ayrıca SIM, eksik değerlere karşı çok hassastır ve temel gerçek yoğunluğunu hesaba katmayan tahminleri cezalandırır.
İnsan ve Hayvan Araştırmaları.
Memphis Üniversitesi Kurumsal İnceleme Kurulu, bu çalışmanın İnsan Denekleri Araştırma Koruma Ofisi'nin insan denek araştırmaları tanımına uymadığını ve 45 CFR bölüm 46'nın geçerli olmadığını belirledi. Dolayısıyla bu çalışma IRB onayı veya incelemesi gerektirmemektedir.
Deneysel sonuçlar Veri analizi.
Toplanan veriler, seçilen konumların (Şekil 3), seçilen sınıfların (Şekil 2) dağılım sırası ve ardışık bölümler arasındaki süre (Şekil 2) açısından görselleştirilebilir. Bu dağılımlar üç veri kümesi için de oldukça benzerdir. Herhangi bir sayı veya alfabe için, seçilen konumların son bölümden sonraki dağılımı, veri kümesindeki kendi sınıfının piksel yoğunluklarının dağılımına benzer. Ancak seçilen konumların sırası doğası gereği stokastiktir. Sınıf dağılımı, katılımcıların birden fazla sınıf seçtiği ilk birkaç bölümde benzer yapılara sahip kategoriler arasındaki karışıklığı gösterir. Daha fazla örneklemeyle bu karışıklık azalır. Karışıklık derecesi (seçili sınıflar/toplam sınıf sayısı) ile örnekleme süresi arasında önemli bir pozitif korelasyon vardır (bkz. Şekil 4). Seçilen ders sayısı fazla (düşük) ise ardışık bölümler arasındaki süre yüksek (düşük) olur. Bir katılımcının bir sınıf için seçtiği konum sırasının CC'si anlamlı değildir (Tablo 1). Bu, statik görüntülerin örneklenmesindeki denekler arası değişkenlik nedeniyle beklenen bir durumdur. Bir katılımcının bir sınıfı doğru bir şekilde tahmin edebilmesi için ihtiyaç duyduğu ortalama örnekleme sayısı oldukça düşüktür. Ortalama olarak MNIST, EMNIST büyük harf ve küçük harf görüntülerini doğru şekilde sınıflandırmak için sırasıyla 36, 44,1 ve 48,1 saniyeye karşılık gelen 4,2, 4,7 ve 4,9 örnek gerekir. Katılımcılar, rakam, büyük harf ve küçük harfli alfabe görüntüsünü doğru bir şekilde sınıflandırmak için görüntü alanının ortalama olarak yalnızca %11,3, %13,4 ve %13,7'sini görüntülediler (ek materyaldeki Şekil S2'ye bakın). Bu sonuçlar, göz izleme verilerinden daha düşük bir çözünürlükte, ancak daha az gürültü ve değişkenlik ile de olsa, insanın görsel muhakeme sisteminin verimliliğini vurgulamaktadır. Bu ampirik sonuçlar, gerçek dünya uygulamalarına yönelik dikkat temelli modeller tasarlamak için faydalı olabilir. Davranış tahmini. Bu bölümde temel modelimizin performansı, her bir katılımcının konumunu ve sınıf seçimini ne kadar doğru tahmin edebildiği açısından değerlendirilmektedir. İki belirginlik puanlama fonksiyonu olan KL diverjansı ve farkı kullanan deneysel sonuçlarımız oldukça benzer olduğundan, aksi belirtilmedikçe sonuçlar yalnızca fark kullanılarak rapor edilir. Sınıf tahmini. Sınıf tahmini ve doğruluk değerlendirme yöntemleri "Sınıf tahmini" bölümünde açıklanmaktadır. Şekil 5'te gösterilen sınıf tahmin doğruluğu, tüm örneklemeler için tüm sınıflar üzerinden hesaplanır. Tüm örneklemeler ve veri kümeleri üzerindeki ortalama sınıf tahmin doğruluğu %74,4'tür (std. sapma 26,5). Şekil 5a ve b, katılımcılar tarafından ve temel modelimiz (Denklem 2) tarafından seçilen sınıf kümesinin ilk bölümlerde oldukça hatalı olduğunu ve örneklerin artmasıyla geliştiğini göstermektedir. Şekil 5c, ilk bölümler sırasında bu iki kümenin (ct ve ct) oldukça farklı olduğunu göstermektedir; örneklerin artmasıyla benzerlik artar. Aynı durum yeni sınıf seçimleri için de geçerlidir (bkz. Şekil 5f). Ancak sınıf reddi ilk bölümlerde benzerdir; benzerlik daha fazla örnekle daha da artar (ref. Şekil 5e). J(st, ˆst)=|(ct ∩ ˆct) − ct−1| |(ct ∪ ˆct) − ct−1| ve J(rt, ˆrt)=|ct−1 − (ct ∪ ˆct)| |ct−1 − (ct ∩ ˆct)|, Şekil 5e, f'den ilk bölümlerde ct−1 ile ct ∪ ˆct arasındaki kesişimin küçük olduğu çıkarılabilir; bu da başlangıçta katılımcıların ve temel modelimizin olduğunu gösterir. ardışık bölümler arasında sınıf seçimlerinde birçok değişiklik yaparlar. Bu nedenle, başlangıçta sınıf seçim süreci oldukça stokastiktir. İlk bölümlerde katılımcıların ve modelimizin sınıf tahmini arasında bazı farklılıklar olsa da, örnekler arttıkça davranışlar giderek benzer hale geliyor. İlk birkaç (genellikle 4 ila 7) bölüm sırasında, bir uyaranın oldukça belirgin kısımları ortaya çıkar. Bu, daha sonraki örneklemelerde yalnızca doğru sınıfın seçilmesine yardımcı olur ve bu da tahmin doğruluğunu artırır. Ortalama şablonları, ilk birkaç bölüm boyunca uyaranın gözlemlenen kısımlarıyla eşleşen birçok sınıf olduğundan, sınıf seçim süreci önemli ölçüde daha stokastiktir ve bu da modelimizin yanı sıra katılımcılarda da düşük sınıflandırma doğruluğuna yol açar.

Şekil 3. Her sayı/alfabe sınıfı ve her örnekleme bölümü için örnekleme konumlarının tüm katılımcılara dağılımı. Her satır bir sınıfa, her sütun soldan sağa doğru artan bir örnekleme bölümüne karşılık gelir.
Konum tahmini. Temel modelimizin (Denk. 3) konum tahmini doğruluğu, tüm örneklemeler ve veri kümeleri üzerinden ortalama olarak %67,7'dir (std. sapma 14.1) (ref. Şekil 5d). Bu tahmin doğruluğunun eğilimi, sınıf tahmin doğruluğunun tersidir. Ancak açıklama aynı kalıyor. İlk örneklemeler sırasında konum tahmin doğruluğu yüksektir çünkü bu bölümler sırasında, oldukça belirgin konumlar seçilir ve daha az belirgin konumlar sonraki bölümlerde seçilmeye bırakılır. Düşük belirginliğe sahip birçok konum olduğundan, bunların seçim süreci oldukça stokastiktir ve bu nedenle tahmin edilmesi zordur, bu da örnekleme sayısındaki artışla birlikte tahmin doğruluğunun azalmasına yol açar. Sınıfların sayısı ve ayrımcılık için yararlı olan oldukça belirgin konumların sayısı veri kümeleri arasında değiştiğinden, azalma eğilimi her veri kümesi için benzersizdir (ref. Şekil 5d). Sınıf sayısı ve ayırt ediciliği yüksek konumların sayısı ne kadar düşük olursa, örneklemelerin artmasıyla birlikte konum tahmin doğruluğundaki azalma da o kadar hızlı olacaktır.
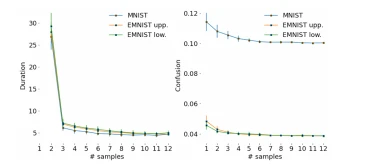
Şekil 4. (Sol) Tüm sınıflar üzerinden ortalaması alınan ardışık örnekler arasındaki zaman farkının (saniye) hata çubuğu grafiği. Tat, t örnekleme bölümünde gösterilen değer, katılımcının t - 1 ile t anındaki görüntüye tıklamaları arasında geçen süredir. (Sağda) Her bölümde tüm sınıfların ortalaması alınan hata çubuğu kafa karışıklığı grafiği. Hata çubukları std'yi gösterir. dev.

Şekil 5. Temel modelimizin değerlendirilmesi (bkz. "Davranış tahmini için temel çizgi" Bölümü). (a) Katılımcıların sınıflandırma doğruluğu (acc.) ve (b) temel gerçek olarak gerçek etiketlerle temel modelimizin doğruluğu. (c) Sınıflandırma benzerliği (J(ct, ˆct)), (d) konum tahmin doğruluğu, (e) sınıf reddetme doğruluğu ve (f) temel model olarak katılımcıların verileriyle temel modelimizin sınıf seçim doğruluğu. Ayrıntılar için "Davranış tahmini" bölümüne bakın.

Tablo 1. Aynı sınıfa ait sabitleme dizileri için ortalama Pearson korelasyon katsayısı (düzeltilmiş). Herhangi bir sabitleme için mesafe Öklidyendir ve yön, orijin olarak uyaranın merkezine göre kutup açısı olarak ölçülür. Std. dev. parantez içinde yer almaktadır.
RAM'in değerlendirilmesi.
Her sınıf ve örnekleme için, RAM'den gelen sabitleme haritaları (github.com/hehefan/Recurrent-Attention-Model'deki RAM uygulamasını kullandık) ve MTurk'ta sunulan aynı uyaranlar için toplanan veriler karşılaştırılır. Katılımcılarla adil bir karşılaştırma yapmak için, RAM'de dizi uzunluğunu görüntü merkezindeki ilk örnekleme konumu olan T=12'ye sabitledik, giriş gözlemini seçilen konumun merkezi olduğu 5x5'lik bir yamaya ve ve ödül fonksiyonunu Eşitlik ile değiştirdi. (1). Kümülatif ödül, Denklemdeki Rt. (4,) Denklem 2'den elde edilen t τ=1 Pτ kümülatif puanı ile değiştirilir. (1). Bir katılımcı herhangi bir bölümde birden fazla sınıf seçebildiğinden, RAM modeli için, en yüksek olasılığa dayalı tek bir sınıfı tahmin etmek yerine, tüm sınıflar üzerindeki ortalama olasılığı bir eşik olarak kabul ediyoruz ve sınıflar kümesini (ct) tahmin edilenden daha büyük olasılıklarla tahmin ediyoruz. eşik. Bu CT Denklem kullanılarak skorun hesaplanması için kullanılır. (1). Bu koşullar altında RAM'in MNIST rakamlarını, büyük harf ve küçük harf EMNIST alfabelerini tanıması için 3,7, 8,5 ve 7,6 örnek gerekir; bunlar sırasıyla görüntü alanının %8,9, %21,0, %18,7'sine karşılık gelir. Dolayısıyla katılımcılarımızla karşılaştırıldığında (bkz. "Veri analizi" bölümü), RAM daha az verimlidir. Bkz. Tablo 2. RAM'den alınan sabitleme haritaları ile toplanan verilerin karşılaştırılmasından elde edilen sonuçlar Tablo 3'te gösterilmektedir. KL, sıfır değerlerine duyarlılığı nedeniyle daha yüksektir. Bu, çeşitli konumların katılımcılar tarafından örneklendiği ancak RAM tarafından örneklenmediği anlamına gelir. Bu deneyler, bir dikkat modeliyle örneklenen konumların değerlendirilmesi için bir temel olarak kullanılabilir.

cistanche faydaları - Belleği Geliştirin
Tartışmalar
Bu yazıda kullanıldığı şekliyle mcAT paradigmasının, nesne tanıma mekanizmalarını incelemek için öncelikle göz hareketlerine ve bakışlara dayanan paradigmalardan bazı farklılıkları vardır. İkincisinde, ilk önce sahnenin göze çarpan kısımları dikkati çeker, ardından göz bakışını göze çarpan yerlere yönlendiren seğirmeli göz hareketleri gelir27. Bakış, dikkat çekici bilgilerle birlikte nesne tanıma için göz hareketlerini yönlendiren öncelik haritalarını oluşturan aşağıdan yukarıya ve yukarıdan aşağıya sinyallerle yönlendirilir. Mevcut çalışmadaki katılımcılar statik görüntülere serbest görüntüleme koşulları altında ve yeterli zaman ayırarak (T=12 örneklemeleri için altı dakika) baktıklarından, muhtemelen bir dizi seğirmeli göz hareketi veya görsel muhakeme28 ile meşgul olmuşlardır. AOI'ye tıklamadan önce görüntü. Bu göz hareketleri emAT'ta (bir göz takip cihazı kullanılarak) yakalanabilirdi ancak mcAT'ta yakalanamazdı. Ancak bu göz hareketleri zihin bulanıklığından etkilenir. mcAT aynı zamanda zihin bulanıklığından da etkilense de29, katılımcılar görsel muhakeme sonrasında yanıt verdiklerinde etki azalabilir. Bir uyarana yanıt olarak göz hareketleri eldeki görevden etkilendiğinden30, katılımcıların göz hareketi modelleri muhtemelen her örneklemede atanan üç adımlı görevden etkilenmiştir (bkz. "Görsel görev" bölümü). Bir göz takip cihazı kullanılmış olsaydı, katılımcıların numuneyi keşfetmeye yönelik göz hareketleri, seçtikleri sınıflara tıklamaya yönelik göz hareketleriyle karıştırılacaktı ve bu, numunenin görsel keşfinin yorumlanmasını karmaşık hale getirecekti. Sınıf(lar)a tıklamak gerekli bir adımdır çünkü içsel olarak da olsa katılımcının zihnindeki tahmin edilen sınıf(lar)ı ortaya çıkarır. Muhtemelen AOI seçiminin hemen öncesinde ve sonrasındaki bakışlar (belki sabit göz hareketlerinin de yardımıyla{10}}rakam/alfabe tanımaya en fazla katkıyı sağlamıştır. Aslında katılımcıların, sınıflar arasında ayrım yapmak için görüntünün tanısal alanlarını seçtiklerini ve bu alanların muhtemelen aşağıdan yukarıya (örneğin görsel kontrast) ve yukarıdan aşağıya (sayı/alfabe şablonu) tanısal bilgilerin bir karışımını içerdiğini tahmin ediyoruz. Bu, katılımcıların (ortalama 5 örnek içinde) tanısal yamaları seçerek uyarıcı sınıfları arasında hızlı bir şekilde ayrım yaptığını gösteren bulgumuzla tutarlıdır.
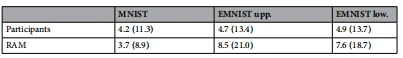
Tablo 2. Bir rakamı/alfabeyi tanımak için gereken ortalama örnek sayısı açısından katılımcılarımız ile RAM modeli arasındaki verimliliğin karşılaştırılması. Gözlemlenen görüntü alanının yüzdesi parantez içinde verilmiştir.
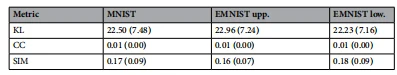
Tablo 3. Tüm sınıflar ve örneklemeler üzerinden ortalaması alınan MTurk deneylerinde sunulan uyaranlar için RAM'den sabitleme haritalarının değerlendirilmesi. Std. dev. parantez içinde yer almaktadır.
Sonuçlar
Sıralı örnekleme yoluyla el yazısıyla yazılmış rakamları ve alfabeleri tanımak için bir mcAT veri kümesi sunduk. Veriler, kıyaslama veri kümelerinden (MNIST, EMNIST) seçilen görsellerle sunulan 382 katılımcıdan toplanmıştır. Ortalama olarak rakam/alfabe sınıfı başına 169,1 yanıt kaydedilir. Veriler, insanın görsel tanıma verimliliğini ortaya çıkarmak için titizlikle analiz ediliyor. Katılımcılar tanıma amacıyla bir görüntünün yalnızca %12,8'ini gözlemlediler. Bir katılımcının bir sonraki örneklemede seçeceği konumu ve sınıf(lar)ı tahmin etmek için bir temel model önerdik. Dikkate dayalı bir güçlendirme modelini insan performansıyla karşılaştırmalı olarak değerlendirmek için deneysel koşullarımızın ve verilerimizin nasıl kullanılabileceğini gösterdik. Göz izleme verilerine göre çok sayıda avantaja sahip olan bu mcAT veri seti, yapay zeka, makine öğrenimi ve diğer alanlarda dikkat temelli model araştırmalarında önemli bir boşluğu dolduruyor.
Referanslar
1. Ranzato, MA Nereye bakılacağını öğrenmek üzerine. arXiv:1405.5488, (2014).
2. Ba, J., Salakhutdinov, RR, Grosse, RB, & Frey, BJ Uyanık uyku-tekrarlayan dikkat modellerinin öğrenilmesi. NIPS'de, 2593–2601 (2015).
3. Mnih, V. ve diğerleri. Tekrarlanan görsel dikkat modelleri. NIPS'de, 2204–2212 (2014).
4. Ba, J., Mnih, V. ve Kavukcuoğlu, K. Görsel dikkatle çoklu nesne tanıma. arXiv:1412.7755 (2014).
5. Dutta, JK & Banerjee, B. Kısa bakış sayısıyla sınıflandırma doğruluğundaki değişim. IJCNN'de, 447–453 (IEEE, 2017).
6. Larochelle, H. & Hinton, GE Fovea bakışlarını üçüncü dereceden bir Boltzmann makinesiyle birleştirmeyi öğreniyor. NIPS'de, 1243–1251 (2010).
7. Elsayed, G., Kornblith, S. & Le, QV Saccader: Görme için yoğun dikkat modellerinin doğruluğunun iyileştirilmesi. NIPS'de, 702–714 (2019).
8. van Beers, RJ Te sakkadik göz hareketlerindeki değişkenliğin kaynakları. J. Neurosci. 27(33), 8757–8770 (2007).
9. Itti, L. & Baldi, P. Bayesian'ın sürprizi insanın dikkatini çekiyor. Vis. Res. 49(10), 1295–1306 (2009).
10. Egner, S. ve diğerleri. Dikkat ve bilgi edinme: Fare tıklamasının göz hareketi dikkat takibi ile karşılaştırılması. J. Göz Mov. Res. 11(6), (2018).
11. Peterson, MS, Kramer, AF & Irwin, DE Dikkatin gizli kaymaları istemsiz göz hareketlerinden önce gelir. Algı. Psikofiz. 66(3), 398–405 (2004).
12. Jiang, M. ve diğerleri. Silikon: Bağlamda belirginlik. CVPR'de, 1072–1080 (2015).
13. Kim, NW ve diğerleri. BubbleView: Görüntü önemi haritalarının kitlesel olarak kaynaklanması ve görsel dikkatin izlenmesi için bir arayüz. ACM Trans. Hesapla. Hımm. Etkileşime girmek. 24(5), 1–40 (2017).
14. Sermanet, P., Frome, A. & Real, E. İnce taneli sınıflandırmaya dikkat. arXiv:1412.7054 (2014).
15. Egner, S., Itti, L. & Scheier, C. Dikkat modellerinin farklı davranış verileriyle karşılaştırılması. Araştır. Oftalmol. Vis. Bilim. 41(4), S39 (2000).
16. Navalpakkam, V. ve diğerleri. Doğrusal olmayan sayfa düzenleri varlığında göz-fare davranışının ölçülmesi ve modellenmesi. Proc'ta. Uluslararası Konf. WWW, 953–964 (2013).
17. Matzen, LE, Stites, MC & Gastelum, ZN Göz takip cihazı olmadan görsel aramanın incelenmesi: Yapay foveasyonun değerlendirilmesi. Biliş. Res. Prens. Örtülü. 6(1), 1–22 (2021).
18. Tafi, AP ve ark. Hizmet olarak OCR: Google Dokümanlar OCR, Tesseract, ABBYY FineReader ve Transym'in deneysel bir değerlendirmesi. Int. Semp. Vis. Comp., 735–746 (Springer, 2016).
19. Memon, J., Sami, M., Khan, RA & Uddin, M. El yazısı optik karakter tanıma (OCR): Kapsamlı bir sistematik literatür taraması (SLR). IEEE Erişimi 8, 142642–142668 (2020).
20. Chaudhuri, A., Mandaviya, K., Badelia, P. & Ghosh, SK Optik karakter tanıma sistemleri. Sof Computing ile Farklı Diller İçin Optik Karakter Tanıma Sistemlerinde, 9–41 (Springer, 2017).
21. LeCun, Y. ve diğerleri. Belge tanımaya uygulanan gradyan tabanlı öğrenme. Proc. IEEE 86(11), 2278–2324 (1998).
22. Cohen, G., Afshar, S., Tapson, J. & van Schaik, A. EMNIST: MNIST'in el yazısı harflere uzantısı. arXiv:1702.05373, (2017).
23. Gregor, K., Danihelka, I., Graves, A., Rezende, D. & Wierstra, D. DRAW: Görüntü üretimi için tekrarlayan bir sinir ağı. ICML'de, 1462–1471 (2015).
24. Friston, K. Te Serbest Enerji Prensibi: Beyne yönelik kaba bir rehber?. Trendler Biliş. Bilim. 13(7), 293–301 (2009).
25. Mirza, MB, Adams, RA, Friston, K. & Parr, T. Aktif çıkarıma dayalı Bayesian seçici dikkat modelinin tanıtılması. Bilim. Temsilci 9(1), 1–22 (2019).
26. Bylinskii, Z., Judd, T., Oliva, A., Torralba, A. & Durand, F. Farklı değerlendirme ölçümleri bize belirginlik modelleri hakkında ne söylüyor? IEEE Çev. Desen Anal. Mach. Intel. 41(3), 740–757 (2018).
27. Itti, L. & Koch, C. Görsel dikkatin hesaplamalı modellenmesi. Nat. Rahip Neurosci. 2(3), 194–203 (2001).
28. Lamme, VAF Bilinçli görmeyi sağlayan görsel işlevler. Ön. Psychol., 11, (2020).
29. da Silva, MRD & Postma, M. Gezinen zihinler, gezinen fareler: Zihin gezintisini tespit etmek için bir yöntem olarak bilgisayar fare takibi. Hesapla. Hımm. Davranış. 112, 106453 (2020).
30. Schütz, AC, Braun, DI & Gegenfurtner, KR Göz hareketleri ve algı: Seçici bir inceleme. J. Vis. 11(5), 9–9 (2011).
31. Intoy, J. & Rucci, M. İnce ayarlı göz hareketleri görme keskinliğini artırır. Nat. İletişim 11(1), 1–11 (2020).


